Critique
Activité bloquée, données ou sécurité en jeu
Intervention immédiate et escalade rapide.

Informatique
Dans une PME, le support utilisateur devient vite un sujet visible parce qu’il touche aux journées de travail. Un mot de passe oublié, une imprimante qui bloque, un accès métier absent, une messagerie lente ou une application qui plante peuvent paraître petits séparément. Additionnés, ces incidents consomment du temps opérationnel, de la patience et parfois la confiance dans l’informatique, surtout quand les mêmes blocages reviennent sans trace claire ni responsable identifié.
Le bon support n’est pas celui qui répond à tout en urgence. C’est celui qui sait trier, résoudre, documenter et apprendre.
Organiser le support utilisateur en PME consiste donc à créer un cadre simple : où demander de l’aide, quelles informations fournir, comment prioriser, qui intervient, à quel moment escalader et quels indicateurs suivre. L’objectif n’est pas de copier un service ITSM de grand groupe. Il est de construire un support lisible, assez structuré pour ne plus dépendre des messages dispersés, sans devenir une usine à tickets.
Organiser le support utilisateur en PME suppose de clarifier la relation quotidienne entre utilisateurs, responsable IT, prestataire et direction. L’approche reste volontairement pragmatique : pas de promesse de résolution immédiate, pas de comparatif exhaustif d’outils, mais une méthode pour faire baisser le bruit et remonter les vrais sujets.
La première erreur consiste à appeler “support” tout ce qui passe par l’informatique. Dans ce cas, le canal reçoit des demandes de dépannage, d’achat, de formation, d’accès, de projet, de sécurité et même de choix métier. Le tri devient flou, les réponses se dispersent et les urgences finissent par masquer les demandes structurantes, celles qui devraient être planifiées, budgétées ou validées par un responsable.
Une PME gagne à distinguer quatre familles. Les incidents bloquent un usage qui fonctionnait auparavant : poste inutilisable, réseau inaccessible, application indisponible. Les demandes de service ajoutent ou modifient quelque chose : créer un compte, installer un logiciel, donner accès à un dossier. Les questions d’usage relèvent plutôt de l’accompagnement ou de la documentation. Les projets, eux, nécessitent un cadrage à part, avec budget et planning.
Cette séparation change la relation avec les utilisateurs. Elle évite de traiter une ouverture de compte comme une panne critique, ou une panne de serveur comme une simple question. Elle permet aussi d’expliquer pourquoi certaines demandes attendent, alors que d’autres passent devant. Le support devient moins arbitraire.
Le cadre doit rester court. Une page interne ou un message de référence suffit souvent pour dire : voici le canal, voici les informations à fournir, voici les cas urgents, voici ce qui relève d’un projet. La règle écrite évite les négociations à chaque incident.
| Famille | Exemple PME | Réponse attendue | Risque si tout est mélangé |
|---|---|---|---|
| Incident | Messagerie bloquée, poste qui ne démarre plus | Restaurer le service | L’urgence réelle se perd dans le flux |
| Demande de service | Créer un compte, installer une licence | Appliquer une procédure validée | Les accès deviennent incontrôlés |
| Question d’usage | Comment partager un fichier ou régler une réunion | Répondre ou orienter vers une fiche | Le support refait la même explication |
| Projet | Changer d’ERP, migrer la téléphonie | Cadrer hors file de tickets | Un gros chantier avance par micro-demandes |
Un canal dispersé finit toujours par perdre des demandes, même avec une équipe attentive, disponible et de bonne volonté.
Un support utilisateur se dégrade quand les demandes arrivent partout : e-mail personnel du technicien, messages instantanés, appels, couloir, SMS, notes papier. Chaque canal paraît pratique sur le moment. Ensemble, ils créent une mémoire trouée.
Le canal unique peut être un outil de ticketing, une adresse support, un portail simple ou un formulaire interne. Le choix dépend de la taille de l’entreprise et du volume de demandes. Ce qui compte, c’est que la demande soit enregistrée avec assez d’informations pour être comprise, priorisée et reprise si la première personne disponible n’est pas celle qui connaît l’historique.
Il faut toutefois garder une voie d’urgence. Si la production, la caisse, la messagerie, la sécurité ou la facturation est bloquée, l’utilisateur doit savoir comment alerter vite. Cette exception doit être explicite. Sinon, tout devient urgent, et le ticketing perd son intérêt.
Le plus difficile n’est pas l’outil choisi. C’est la constance d’usage pendant les premières semaines, quand les anciennes habitudes reviennent vite.
Le bon message aux équipes est simple : “on garde un canal principal pour ne rien perdre; on conserve un raccourci pour les vraies urgences”. Cette formulation évite l’impression d’un support distant ou bureaucratique. Elle montre que la règle sert la résolution, pas le confort de l’équipe IT.
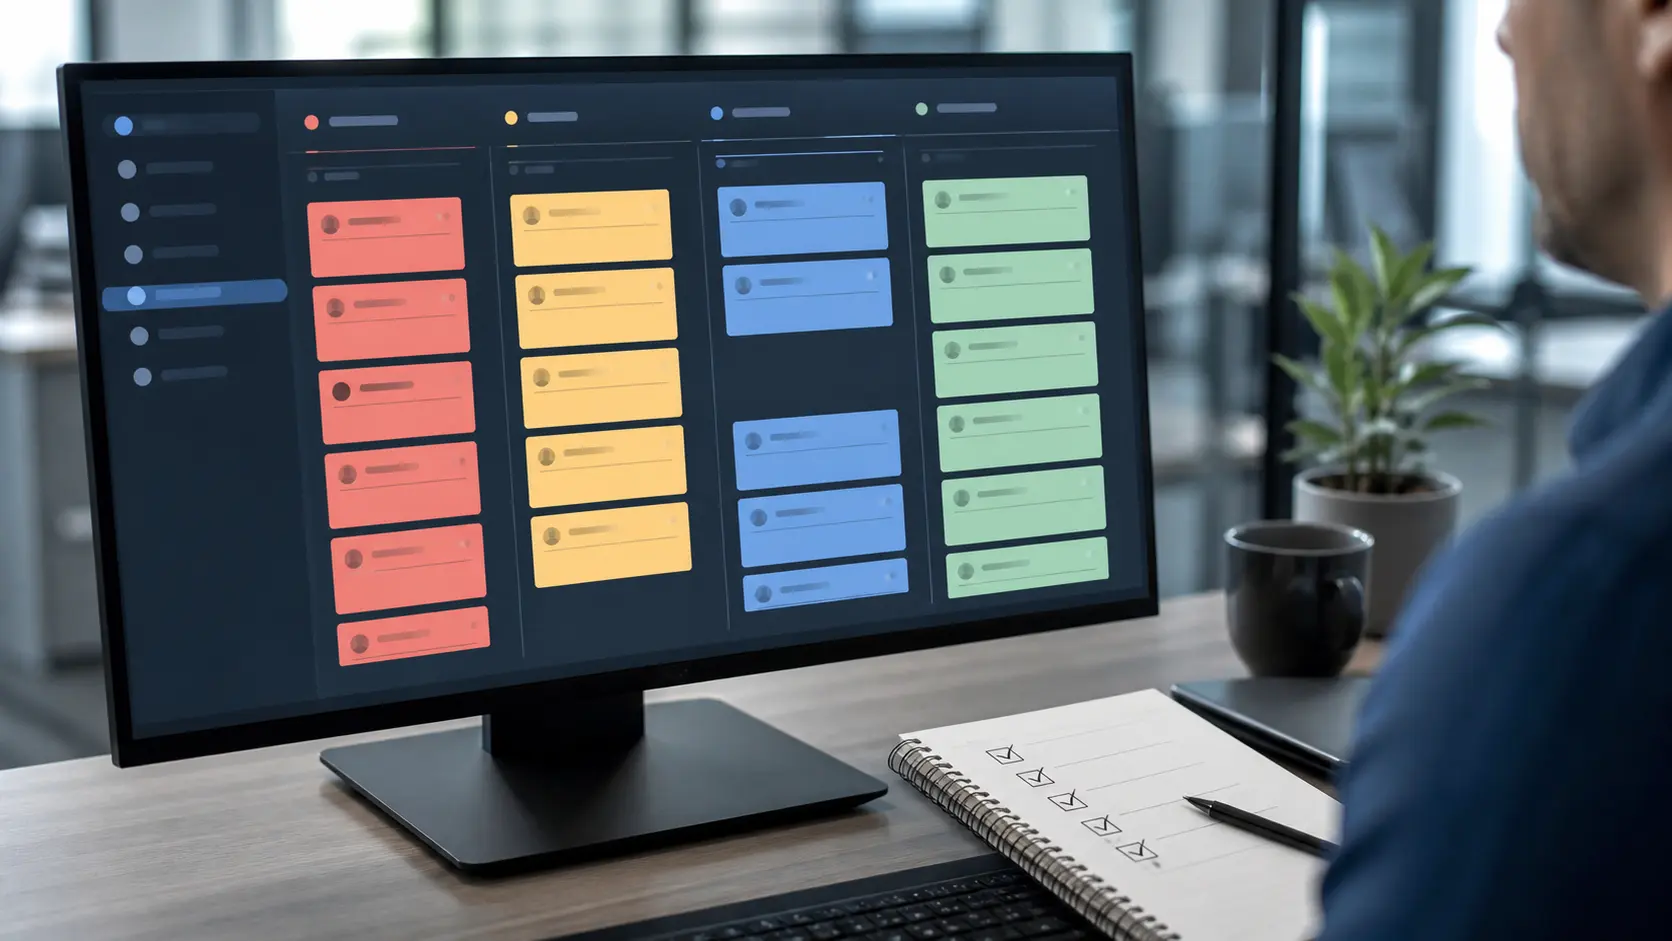
Un ticket pauvre ralentit tout. “Ça ne marche pas” oblige à relancer l’utilisateur, comprendre le contexte, demander une capture, chercher l’équipement et reproduire le problème. À l’inverse, un ticket clair donne immédiatement le point de départ.
Le formulaire doit rester léger. Demandez le service concerné, l’application ou l’équipement, le symptôme, l’heure d’apparition, l’impact métier, le nombre de personnes touchées, les actions déjà tentées et une capture si elle est utile. Pour les accès, ajoutez le nom du manager valideur, le périmètre demandé et la date de besoin.
À consulter également : informatique pme, pour les aspects propres à informatique pme, le guide pour structurer un système fiable.
La difficulté est de ne pas transformer l’utilisateur en technicien. Il ne doit pas diagnostiquer le réseau ou la base de données. Il doit décrire ce qu’il voit, ce qu’il faisait et ce qui est bloqué. Le vocabulaire métier est souvent plus utile qu’un diagnostic approximatif.
Un bon ticket respecte aussi la confidentialité. Les utilisateurs ne doivent pas coller des mots de passe, données clients complètes, pièces sensibles ou captures inutiles contenant trop d’informations. Sur un sujet de support, ce point est important : l’outil devient vite un dépôt de données. Les recommandations CNIL et cyber rappellent que les accès, mots de passe et données personnelles doivent rester maîtrisés.
La priorité doit être lisible avant que la tension ne monte; sinon chacun défend son propre blocage du moment.
Le support PME souffre souvent de la priorité émotionnelle : la dernière personne à appeler passe devant parce qu’elle est inquiète, insistante ou proche du décideur. Ce mode fonctionne quelques jours. Ensuite, il crée de l’injustice et masque les blocages métier les plus coûteux.
La priorité doit combiner quatre critères : impact sur l’activité, nombre d’utilisateurs touchés, risque sécurité ou données, et existence d’un contournement acceptable. Une panne qui bloque dix personnes sans alternative passe devant une gêne individuelle contournable. Une alerte de compte compromis passe devant une demande de confort, même si elle touche une seule personne, car le risque latent dépasse alors la simple gêne utilisateur.
La grille de priorité doit être connue. Elle peut tenir en quatre niveaux : critique, élevée, normale, basse. Le niveau critique concerne les services indisponibles, la sécurité, les pertes de données possibles ou les activités qui ne peuvent pas attendre. La priorité élevée couvre un service important avec contournement limité. Le reste peut être planifié proprement.
Cette discipline évite un piège : promettre trop vite. Le support peut accuser réception, qualifier, donner une estimation prudente et réviser le délai si la cause change. Il ne doit pas garantir une résolution instantanée, surtout quand le problème dépend d’un fournisseur, d’une ligne opérateur, d’un logiciel métier ou d’un audit complémentaire.
Activité bloquée, données ou sécurité en jeu
Intervention immédiate et escalade rapide.
Service important dégradé avec contournement faible
Traitement prioritaire dans la journée selon contexte.
Gêne réelle mais activité maintenue
Planification dans la file standard.
Confort, question ou amélioration non urgente
Regroupement, documentation ou traitement lors d’un créneau dédié.
Un délai clair vaut mieux qu’une promesse héroïque. Il donne un repère fiable sans fabriquer une garantie impossible.
Les SLA internes ne sont pas réservés aux grandes entreprises. En PME, ils servent surtout à dire ce que chacun peut attendre : un délai d’accusé réception, un délai de qualification, une fréquence de mise à jour et les cas où l’escalade est automatique.
La nuance compte. Un délai de prise en charge n’est pas un délai de résolution. Dire “réponse sous quatre heures ouvrées” n’implique pas que le logiciel sera réparé dans le même délai. Cette distinction protège la relation utilisateur et évite les malentendus.
Pour les demandes récurrentes, le support peut publier des délais cibles : création de compte, ajout d’une licence, accès à un dossier, préparation d’un poste, installation d’une imprimante. Ces délais obligent les équipes à anticiper. Ils évitent aussi les demandes RH ou opérationnelles envoyées la veille pour le lendemain, puis transformées en urgence artificielle.
Le délai doit rester compatible avec la réalité : effectif IT, horaires, contrats, fournisseurs, criticité métier et niveau d’externalisation. Un engagement impossible dégrade plus la confiance qu’un engagement modeste mais tenu. La régularité compte davantage que l’affichage ambitieux.
| Engagement | Ce qu’il signifie | Limite à préciser |
|---|---|---|
| Accusé réception | La demande est vue et enregistrée | Ce n’est pas encore une résolution |
| Qualification | Impact, urgence et cause probable sont estimés | La cause peut changer après analyse |
| Mise à jour | L’utilisateur reçoit un point régulier | La fréquence dépend de la criticité |
| Escalade | Un niveau supérieur ou fournisseur est sollicité | Le délai final peut dépendre d’un tiers |
La documentation utile naît rarement d’un grand chantier; elle vient d’abord des questions qui reviennent chaque semaine dans les équipes.
Une base de connaissances n’a d’intérêt que si elle répond aux irritants réels. Si elle contient quinze procédures théoriques mais pas la marche à suivre pour se reconnecter au VPN, partager un fichier ou configurer une imprimante, elle restera ignorée.
Commencez par les demandes répétitives. Les dix tickets les plus fréquents donnent souvent la liste de départ : réinitialisation de mot de passe, accès à un dossier, connexion Wi-Fi invité, signature mail, partage de calendrier, impression, visioconférence, demande de licence, poste nouvel arrivant. Chaque fiche doit être courte, datée, validée et rédigée pour un utilisateur non spécialiste.
Le support doit aussi savoir retirer. Une fiche obsolète peut faire plus de dégâts qu’une absence de fiche, car elle donne confiance à tort. Prévoir un propriétaire et une date de revue évite que la base devienne un cimetière documentaire.
La bonne base de connaissances ne remplace pas le support. Elle absorbe les demandes simples et libère du temps pour les incidents à impact. Elle améliore aussi l’intégration des nouveaux collaborateurs, car les réponses de base ne dépendent plus de la personne assise à côté.
Externaliser le support ne veut pas dire abandonner la maîtrise de l’informatique. Cela peut au contraire clarifier les rôles, à condition de savoir ce qui est délégué et ce qui reste décidé en interne.
Le support de niveau 1 peut être confié à un prestataire quand le volume de demandes dépasse la capacité interne, quand les horaires doivent s’élargir ou quand l’entreprise n’a pas de technicien disponible. Mais la PME doit garder le pilotage : priorités métier, validation des accès, choix des outils, budget et décisions de remplacement. Sans ce noyau interne, le prestataire traite des symptômes sans toujours connaître les arbitrages commerciaux, RH ou financiers qui donnent leur vraie priorité aux incidents.
Un contrat doit préciser le périmètre, les horaires, les délais de prise en charge, les cas d’escalade, les exclusions, la gestion des accès, le reporting et les règles de confidentialité. Sans ces éléments, l’externalisation devient une boîte noire : les tickets sont traités, mais personne ne sait si les causes récurrentes baissent réellement.
Le meilleur modèle est souvent hybride. Le prestataire absorbe les demandes fréquentes et documente les résolutions. L’entreprise garde une personne référente qui arbitre les priorités et lit les indicateurs. Le binôme interne-externe fonctionne mieux qu’une délégation floue.
Le reporting support doit rester utile à la décision. Une PME n’a pas besoin de vingt indicateurs. Elle a besoin de comprendre où part le temps, quelles demandes reviennent, quels services sont le plus touchés et quelles causes méritent un chantier.
Quatre indicateurs suffisent souvent au départ : volume de tickets par famille, délai de première réponse, délai de résolution par priorité, taux de réouverture ou de récidive. Ajoutez une lecture qualitative : les trois irritants du mois, les deux corrections lancées, le risque à surveiller.
Les chiffres doivent déclencher des décisions. Beaucoup de tickets sur les mots de passe peuvent justifier une meilleure procédure, un gestionnaire de mots de passe ou une sensibilisation. Trop de demandes d’accès indiquent peut-être un processus d’arrivée/départ mal cadré. Des incidents réseau récurrents peuvent signaler un équipement vieillissant, une cartographie incomplète ou un contrat opérateur insuffisant. Dans tous les cas, le bon indicateur est celui qui amène une action concrète le mois suivant.
Le reporting perd sa valeur s’il sert seulement à juger le support. Il doit surtout révéler les causes système. Sinon, l’équipe corrige vite, mais rien ne s’améliore durablement.
Le support utilisateur manipule des informations sensibles : comptes, droits, captures, identifiants d’équipement, données clients, parfois données RH ou financières. Une organisation légère ne doit pas devenir une organisation imprudente.
La règle de base est claire : aucune demande d’accès sensible sans validation identifiée. Une création de compte, une élévation de droits, un accès à un dossier partagé ou une réinitialisation critique doit laisser une trace contrôlable. Le support ne doit pas accepter une demande vague envoyée par message rapide quand elle ouvre un périmètre métier important, même si la personne qui demande est connue, pressée ou hiérarchiquement légitime.
Les mots de passe ne doivent jamais circuler en clair dans les tickets. Les captures doivent être limitées à ce qui est utile. Les informations personnelles doivent être minimisées. Pour un sujet ordinaire de support, ces précautions semblent parfois lourdes; elles évitent pourtant que l’outil de ticketing devienne une archive de secrets et de données inutiles.
Enfin, certains incidents doivent sortir du flux normal : suspicion de phishing, compte compromis, fuite de données, ransomware, perte d’un appareil contenant des informations professionnelles. Là, le support ne se contente pas de “réparer”. Il applique une procédure d’escalade, isole si nécessaire, documente et sollicite les compétences adaptées. L’incident cyber n’est pas un ticket comme les autres.
La bonne escalade protège autant les utilisateurs que l’équipe support, car elle évite les gestes rapides mal maîtrisés.
Le premier mois doit prouver que le support devient plus clair, pas que l’outil est parfaitement configuré dans tous ses détails.
La mise en place peut rester progressive. Le risque, sinon, est de lancer un grand projet de support qui ne change rien aux habitudes quotidiennes. Une PME peut obtenir un résultat visible en un mois si elle traite le sujet comme un chantier court.
La première semaine sert à choisir le canal unique et à annoncer les règles. La deuxième semaine permet de qualifier les familles de demandes et les priorités. La troisième semaine crée les premières fiches de base de connaissances à partir des tickets répétitifs. La quatrième semaine installe le reporting minimal et le point mensuel. Ce rythme donne des repères immédiats sans attendre un déploiement parfait.
Il faut accepter une période d’ajustement. Les utilisateurs oublieront le canal, le support demandera parfois trop d’informations, les priorités devront être corrigées. L’important est de tenir le cadre et de le simplifier quand il bloque. Un support bien organisé se reconnaît à sa capacité à améliorer ses propres règles.
La prochaine action est concrète : relire les vingt dernières demandes informatiques, les classer en incidents, services, questions et projets, puis choisir les trois irritants à documenter ou corriger en premier. Cette photographie suffit pour lancer la première version du support utilisateur PME.
Un support utilisateur efficace n’a pas besoin d’une organisation massive. Il a besoin d’un canal clair, de tickets compréhensibles, de priorités explicites, d’une base de connaissances vivante et d’un reporting qui mène à des décisions. C’est cette régularité qui réduit les interruptions et rend l’informatique plus fiable au quotidien.
La priorité est donc de sortir du support dispersé. Commencez par centraliser les demandes, qualifier les urgences et documenter les problèmes récurrents. Ensuite seulement, choisissez ou améliorez l’outil. Le bon processus rendra le ticketing utile; l’inverse est rarement vrai.
Ces sources cadrent les points sensibles liés aux accès, aux sauvegardes et aux données. Elles ne remplacent pas un audit de votre système d’information ni vos obligations contractuelles.
Référence publique pour cadrer l'inventaire, les accès, les mises à jour et les pratiques de sécurité de base.
ConsulterRepères pour éviter qu'une demande de support ou une panne ne devienne une perte durable de données.
ConsulterConseils utiles lorsque le support traite des comptes, accès, réinitialisations et risques de partage d'identifiants.
ConsulterRappel des précautions à garder quand des tickets contiennent des données personnelles ou des informations sensibles.
Consulter