Réparer
Incident isolé et cause claire
Pertinent quand le poste reste récent, documenté et sous garantie.

Informatique
Dans une PME, une panne informatique coûte rarement cher uniquement parce qu’un poste ne démarre pas. Elle coûte cher parce qu’elle bloque une personne, décale une livraison, immobilise une équipe ou oblige tout le monde à chercher “qui avait déjà réglé ce problème”. Réduire les pannes informatiques, c’est donc d’abord réduire les incidents répétitifs et les temps morts. Le gain se voit dans les journées qui ne déraillent plus, surtout aux moments de forte activité.
Le bon objectif est simple. Moins d’arrêts, moins de reprises manuelles, moins d’incidents qui reviennent.
La promesse réaliste n’est pas le zéro panne. Elle consiste à connaître son parc, supprimer les causes récurrentes, tester les sauvegardes, préparer quelques remplacements critiques et documenter les incidents. C’est moins spectaculaire qu’un dépannage héroïque, mais beaucoup plus rentable pour une structure de 10, 30 ou 80 postes. Cette stabilité libère aussi du temps pour les vrais projets IT, ceux qui modernisent réellement l’activité et ne se limitent pas aux urgences.
Le bon angle est terrain : on part des pannes qui reviennent, on cherche leur cause commune, puis on décide quoi corriger, quoi surveiller et quoi remplacer. Une panne isolée se dépanne; une panne qui revient se gouverne.
Une PME accumule souvent des correctifs rapides : un poste ajouté en urgence, une imprimante déplacée sans revoir le réseau, une box remplacée sans cartographie, un ancien logiciel gardé “parce qu’il fonctionne encore”. Au bout de quelques années, le système tient, mais il tient par habitudes.
Le problème n’est pas toujours technique au départ. Il vient souvent de l’absence d’inventaire fiable, d’une documentation dispersée, de droits accordés trop largement, d’équipements hors garantie ou de sauvegardes jamais restaurées. Quand une panne survient, chacun cherche dans sa mémoire plutôt que dans une procédure, et le dépannage dépend alors de la personne disponible ce jour-là.
Une panne récurrente est un signal. Si trois personnes ouvrent le même ticket sur une connexion instable, ce n’est pas trois petits incidents indépendants. C’est probablement un sujet de Wi-Fi, de câblage, de DNS, de poste vieillissant, de serveur saturé ou de configuration mal répliquée. Le ticket récurrent doit donc remonter dans la liste des chantiers, pas rester au niveau dépannage, sinon il reviendra au prochain pic d’usage avec plus de pression.
La bonne bascule commence au classement des causes. Pas au choix d’un nouvel outil ou d’un contrat plus cher.
La première décision utile consiste donc à arrêter de classer les incidents par “gêne ressentie” et à les classer par famille de cause. C’est là que la maintenance devient pilotable. Un dirigeant ou un responsable administratif peut alors arbitrer entre remplacement, contrat de support, formation, documentation ou changement d’architecture, sans se limiter au dernier incident entendu.
Sans journal, une PME confond vite dépannage réussi et problème réellement supprimé. Le support perd sa mémoire.
Le journal d’incidents n’a pas besoin d’être lourd. Il doit seulement être régulier. Pour chaque panne, notez la date, l’utilisateur ou le service concerné, l’équipement, le symptôme, la durée d’arrêt, la solution appliquée et la cause supposée. Dix lignes bien tenues valent mieux qu’un outil sophistiqué jamais rempli, surtout si personne ne relit les tickets ensuite pour décider d’une action préventive réelle et mesurable.
Ce journal évite deux erreurs classiques. La première consiste à sous-estimer un problème parce qu’il se règle vite. La seconde consiste à remplacer trop tôt un matériel alors que la vraie cause se trouve dans le réseau, le compte utilisateur, le pilote, le stockage ou la procédure de sauvegarde.
Au bout d’un mois, vous pouvez déjà voir les motifs. Trois lenteurs le lundi matin, deux imprimantes qui décrochent après redémarrage, un serveur de fichiers saturé tous les vendredis, un poste comptable qui plante à chaque mise à jour : ce ne sont plus des anecdotes, ce sont des priorités de maintenance. Cette lecture factuelle évite aussi les débats à l’intuition entre services, car chacun regarde la même trace et le même impact.
| Information à noter | Exemple concret | Pourquoi c’est utile | Décision possible |
|---|---|---|---|
| Équipement touché | Poste accueil, imprimante, switch, NAS | Repère les zones fragiles du parc | Remplacer, surveiller ou standardiser |
| Durée d’arrêt | 15 minutes, 2 heures, journée bloquée | Mesure l’impact réel | Prioriser ce qui coûte le plus |
| Solution appliquée | Redémarrage, changement câble, restauration | Évite de repartir de zéro | Créer une procédure interne |
| Cause probable | Pilote, DNS, stockage plein, droits | Transforme l’incident en piste | Lancer une action préventive |
| Récurrence | 1 fois, 3 fois, hebdomadaire | Distingue panne isolée et panne système | Traiter en chantier prioritaire |
Le point important est d’écrire même quand la panne semble banale. Une imprimante relancée en deux minutes peut cacher un problème de réservation IP. Un poste “lent” peut annoncer un disque fatigué. Une sauvegarde qui échoue une fois peut devenir le jour où aucune restauration propre n’est possible. C’est souvent dans ces petits signaux que se prépare la grosse interruption, celle qui semble soudaine uniquement parce que personne n’a relié les alertes.
Un poste fiable commence par une configuration connue. Il doit rester maintenu et remplaçable sans improvisation, avec une image système, des licences retrouvables, des profils sauvegardés et une procédure de réinstallation. Sans cette base, chaque panne de poste devient une reconstruction artisanale, dépendante de la mémoire de l’utilisateur et du technicien disponible.
Les postes utilisateurs concentrent beaucoup de symptômes : lenteurs, redémarrages, écrans noirs, applications qui se ferment, périphériques qui disparaissent. Pourtant, toutes ces pannes ne demandent pas la même réponse. Il faut distinguer l’usure matérielle, la surcharge logicielle, les mises à jour mal suivies et les profils utilisateurs instables.
Une bonne base consiste à standardiser. Même modèle de poste quand c’est possible, mêmes versions principales, mêmes outils de sécurité, même méthode d’installation, mêmes règles de droits. Plus le parc est hétérogène, plus chaque panne devient un cas particulier. La diversité a un coût de support, même quand chaque achat isolé semblait moins cher au départ.
La maintenance préventive doit couvrir les mises à jour, l’espace disque, l’état SMART des disques quand l’outil le permet, la santé batterie des portables, les logiciels obsolètes, les agents de sécurité et les périphériques critiques. Ce n’est pas un audit complet à chaque fois. C’est une tournée régulière, planifiée et documentée.
Dans une PME, le remplacement doit aussi se décider froidement. Un poste vieux, lent, hors garantie, réparé trois fois et utilisé par un service clé n’est pas “économique”. Il consomme du temps de support, crée de l’attente et augmente le risque d’une panne au mauvais moment.
À lire ensuite, support informatique pme, consacré à organiser le support utilisateur en pme sans créer une usine à tickets.
Incident isolé et cause claire
Pertinent quand le poste reste récent, documenté et sous garantie.
Pannes répétées ou matériel vieillissant
À envisager quand l’interruption coûte plus que le renouvellement.
Parc trop hétérogène
Réduit les cas particuliers et simplifie les procédures de support.
Quand le réseau tombe, les symptômes visibles ne disent pas toujours où se trouve la cause. Il faut remonter calmement.
Beaucoup de pannes “mystérieuses” viennent du réseau. Un poste n’accède plus au serveur, l’imprimante devient hors ligne, une application métier se déconnecte, la téléphonie coupe, le Wi-Fi ralentit en salle de réunion. Si le réseau n’est pas cartographié, chaque incident ressemble à un hasard, alors qu’il dépend parfois d’un seul câble, switch ou bail d’adresse. Le réseau est une dépendance métier, pas un décor technique, et mérite ce niveau de suivi.
Commencez par documenter les points de passage : box ou routeur, pare-feu, switchs, bornes Wi-Fi, NAS, serveurs, imprimantes réseau, liens opérateur. Ajoutez les adresses IP fixes, les réservations DHCP, les VLAN si vous en utilisez, les équipements hors garantie et les câbles critiques. Cette cartographie n’a pas besoin d’être belle; elle doit être exacte, lisible par quelqu’un qui n’a pas installé le réseau et qui intervient sous pression, parfois hors horaires.
Les imprimantes méritent une attention particulière parce qu’elles bloquent encore des flux administratifs, commerciaux ou logistiques. Les pannes viennent souvent de pilotes incohérents, d’adresses changées, de files bloquées, de consommables, de droits ou d’une dépendance à un poste qui sert de relais. Les traiter comme de simples accessoires crée des pertes de temps répétées.
Pour le réseau comme pour les imprimantes, la meilleure prévention reste simple : nommage clair, équipements étiquetés, mots de passe administrateur stockés proprement, supervision minimale, configuration sauvegardée et procédure de remplacement. Quand un switch tombe, savoir quoi débrancher et quoi reconnecter change tout. Sans ces repères, une panne courte devient une enquête improvisée.
Le réseau doit pouvoir être compris sans dépendre d’une seule personne clé. Sinon chaque absence devient un risque.
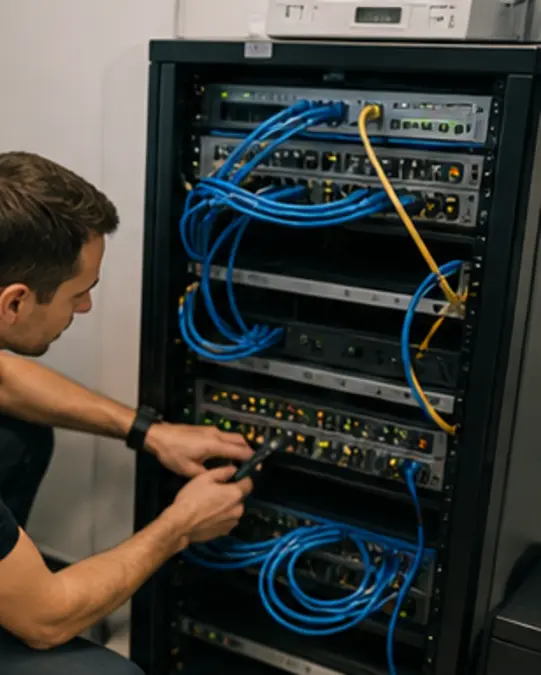
Une sauvegarde non testée rassure sur le papier. Pas le jour de l’incident, quand il faut restaurer vite.
Une sauvegarde qui existe mais qui n’a jamais été restaurée est une promesse fragile. Les sources publiques de cybersécurité insistent sur ce point : il faut organiser la sauvegarde, mais aussi vérifier qu’elle permet réellement de récupérer les données utiles. En PME, c’est souvent le test de restauration qui manque.
La question n’est pas seulement “avons-nous une sauvegarde ?”. Il faut demander : quelles données sont couvertes, à quelle fréquence, où sont-elles stockées, qui reçoit les alertes, combien de versions sont gardées, combien de temps prend la restauration et que fait-on si le serveur principal n’est plus disponible ? Cette liste paraît longue, mais elle tient sur une fiche d’exploitation, et elle évite des décisions improvisées le jour où tout le monde attend la remise en ligne.
Pour les postes de travail, la stratégie dépend des usages. Si les fichiers sont centralisés et synchronisés proprement, le poste peut être remplacé plus vite. Si chaque utilisateur garde des documents locaux non sauvegardés, la panne d’un SSD devient un incident de production et parfois une perte de données.
Une sauvegarde sérieuse doit donc être pensée avec le plan de reprise minimum. Sans promettre de délai magique, une PME peut définir les données prioritaires, les services à redémarrer en premier, les contacts à prévenir et les tests à faire tous les trimestres ou semestres selon le niveau de risque.
Le vrai test n’est pas la copie réussie. C’est la restauration lisible par l’équipe, sans devinette technique.
La maintenance préventive doit être visible et courte. Elle doit surtout être reliée à un risque métier concret : sauvegarde qui échoue, poste critique hors garantie, switch non documenté, logiciel obsolète, compte d’un ancien collaborateur encore actif. Cette façon de présenter les choses rend l’effort acceptable, car chacun comprend ce qui est protégé.
La maintenance préventive échoue quand elle est pensée comme une grande opération annuelle. Elle fonctionne mieux en petites routines : mises à jour, contrôles d’espace disque, vérification des sauvegardes, nettoyage des comptes inutiles, remplacement des câbles douteux, revue des onduleurs et contrôle des équipements réseau.
Le rythme dépend du contexte, mais une PME peut déjà séparer trois niveaux : hebdomadaire pour les alertes et sauvegardes, mensuel pour les postes et mises à jour, trimestriel pour le parc, les comptes, les garanties, les licences et les scénarios de restauration. Cette cadence doit rester compatible avec le travail des équipes, sinon elle sera repoussée jusqu’à la prochaine panne, au moment où elle coûtera le plus cher et où personne ne sera disponible.
Le piège consiste à faire les mises à jour au mauvais moment ou sans retour arrière. Un poste isolé peut être redémarré rapidement. Un serveur, un pare-feu, une application métier ou un stockage partagé demandent un créneau, une sauvegarde récente, un responsable identifié et une fenêtre de test. Là encore, ce n’est pas de la bureaucratie; c’est un plan de retour arrière, indispensable quand la correction touche un service partagé.
| Routine | Fréquence réaliste | À vérifier | Risque si oublié |
|---|---|---|---|
| Alertes sauvegarde | Hebdomadaire | Succès, erreurs, capacité, restauration test | Découvrir trop tard une sauvegarde inutilisable |
| Mises à jour postes | Mensuelle | Système, navigateurs, outils métiers, sécurité | Accumuler failles, bugs et incompatibilités |
| Parc matériel | Trimestrielle | Âge, garantie, état disque, batteries, stocks | Subir des pannes prévisibles |
| Réseau | Trimestrielle | Switchs, Wi-Fi, onduleurs, câblage, configuration | Multiplier les coupures difficiles à diagnostiquer |
| Comptes et droits | Trimestrielle | Comptes sortants, privilèges, accès partagés | Créer des risques et des erreurs d’accès |
Un calendrier partagé avec les managers suffit souvent à calmer les tensions. Les utilisateurs comprennent mieux une interruption courte annoncée qu’une panne longue subie. La maintenance devient alors un service rendu à l’activité, pas une contrainte technique invisible.
Une maintenance annoncée dérange moins qu’une panne subie en pleine journée. Les équipes peuvent s’organiser.
Remplacer n’est pas toujours dépenser plus. C’est parfois arrêter une fuite de temps et de support.
Le remplacement n’est pas un aveu d’échec. C’est parfois la décision la plus rationnelle. Un serveur en fin de garantie, un NAS saturé, un poste instable, une imprimante trop coûteuse ou un switch ancien peuvent absorber des heures de support sans jamais redevenir fiables. Réparer encore une fois peut coûter plus cher que stabiliser une bonne fois, surtout quand l’équipement critique bloque plusieurs métiers et revient chaque mois dans les incidents.
Pour décider, additionnez le coût caché des interruptions : temps utilisateur perdu, délais clients, support externe, stress, contournements, erreurs de saisie, retard de facturation, risques de données. Ce coût n’apparaît pas toujours dans la ligne “matériel”, mais il existe dans l’activité.
La bonne décision se prend par criticité métier. Un poste secondaire peut attendre. Une machine utilisée pour la paie, la facturation ou la production mérite une tolérance plus faible. Un équipement réseau qui coupe plusieurs services mérite une priorité plus haute qu’un périphérique isolé.
Gardez aussi une petite réserve : câbles, adaptateurs, clavier, souris, disque externe de dépannage, poste reconditionné prêt à l’emploi si le contexte le justifie. Ce stock n’élimine pas les pannes, mais il réduit le temps passé à attendre une livraison pour une pièce banale.
La décision doit être économique, technique et opérationnelle.
Les utilisateurs signalent mieux les problèmes quand ils comprennent ce qui sera fait de l’information. Le retour compte : si une lenteur signalée débouche sur une correction visible, l’équipe continuera à remonter les signaux faibles. Si les alertes disparaissent dans un silence complet, les collaborateurs attendront la vraie panne pour parler.
Les pannes informatiques ne se réduisent pas uniquement dans la salle serveur. Elles se réduisent aussi dans les usages. Un collaborateur qui reporte une alerte, évite les rallonges hasardeuses, respecte les redémarrages planifiés et signale une lenteur récurrente aide réellement la maintenance. L’utilisateur devient alors une source d’information, pas seulement la personne qui subit le problème.
La communication doit rester concrète. Au lieu de dire “ne faites pas n’importe quoi”, expliquez pourquoi certains comportements déclenchent des incidents : stockage local non sauvegardé, poste jamais redémarré, multiprises saturées, impressions massives au dernier moment, fichiers lourds échangés par mail ou mot de passe partagé entre collègues.
Une charte courte peut suffire si elle est vivante. Elle doit dire quoi signaler, à qui, avec quelles informations, et ce qu’il ne faut pas tenter seul. Il ne s’agit pas d’infantiliser les équipes, mais de créer un réflexe de remontée avant que le petit symptôme ne devienne panne longue.
Ils demandent peu d’outillage, mais changent vite la qualité du support.

Noter symptôme, durée, cause probable et solution évite de redécouvrir la même panne.

Un calendrier court et visible évite les mises à jour improvisées au mauvais moment.

Une sauvegarde devient utile seulement quand sa restauration a été vérifiée.
Le plus efficace est de commencer petit. Pendant 30 jours, notez tous les incidents, même mineurs. Classez-les par famille : postes, réseau, imprimantes, applications, stockage, sauvegardes, droits. À la fin du mois, choisissez trois causes récurrentes à traiter, pas quinze.
Ensuite, créez une action par cause : corriger une configuration réseau, remplacer deux postes critiques, tester une restauration, nettoyer les comptes inutiles, standardiser les pilotes d’imprimante, ajouter une supervision simple ou planifier les mises à jour. Chaque action doit avoir un responsable, une date et un critère de réussite.
Le mois suivant, mesurez. Si les incidents diminuent, gardez le rythme. S’ils reviennent, cherchez la cause plus haut : fournisseur, architecture, matériel, procédure, formation ou contrat d’infogérance. Une PME n’a pas besoin d’une usine à processus; elle a besoin d’un cycle court d’amélioration.
Trois indicateurs suffisent souvent pour commencer : nombre d’incidents récurrents, durée cumulée d’interruption et temps passé à corriger. Ils donnent une lecture plus juste que le simple nombre de tickets, car une panne rare mais longue peut coûter davantage que cinq petits incidents vite résolus.
Ajoutez ensuite un indicateur de prévention : taux de sauvegardes réussies, restaurations testées, postes à jour, équipements hors garantie ou incidents sans cause documentée. Ces chiffres ne servent pas à remplir un tableau pour le plaisir. Ils servent à décider où mettre le prochain budget.
Un tableau mensuel suffit, à condition qu’il serve vraiment à décider une action concrète le mois suivant.
Le but n’est pas de punir l’équipe informatique ou le prestataire. Le but est de repérer les zones qui consomment du temps et qui méritent une action durable. Si 40 % des incidents viennent de l’impression, le chantier n’est pas une nouvelle astuce de dépannage; c’est la standardisation des pilotes, des files, des adresses et du support consommable, avec un responsable identifié et une échéance suivie par la direction.
Quand vous présentez ces indicateurs à la direction, évitez le jargon. Dites plutôt : “ce mois-ci, les pannes réseau ont bloqué 14 heures cumulées; remplacer ce switch et documenter la configuration coûte moins cher que continuer comme ça”. C’est ce langage qui transforme la maintenance en décision de gestion.
Une panne critique donne envie d’aller vite. C’est normal. Mais certaines réactions aggravent la situation : redémarrer un serveur sans comprendre l’impact, supprimer des fichiers pour libérer de la place, modifier une règle réseau au hasard, réinstaller un poste sans sauvegarde ou partager un mot de passe administrateur pour “gagner du temps”.
Le dépannage doit protéger les données et laisser une trace exploitable.
La bonne urgence reste encadrée. On identifie le service touché, on protège les données, on garde une trace de ce qui est tenté, puis on applique une procédure connue ou on escalade vers la bonne personne. Si la panne touche la sécurité, la sauvegarde, la messagerie, le serveur de fichiers ou une application métier critique, l’improvisation doit rester minimale. C’est dans ces moments que les erreurs les plus coûteuses arrivent.
Une action rapide doit pouvoir être expliquée ensuite, sinon la correction devient impossible à contrôler ou à corriger proprement.
Après la résolution, organisez un retour court : cause confirmée, durée réelle, décision préventive, documentation à mettre à jour. Ce retour ne doit pas devenir une réunion lourde. Dix minutes suffisent si l’équipe repart avec une action claire, un responsable et une date.
Ce travail paraît modeste, mais il change le rapport aux incidents. Au lieu d’avoir des pannes qui disparaissent dès que le service revient, vous construisez une mémoire opérationnelle. C’est elle qui réduit les prochaines interruptions.
Le sujet n’est pas de tout contrôler. Il est de rendre les incidents prévisibles moins fréquents.
Réduire les pannes informatiques en PME ne dépend pas d’un outil miracle. Cela dépend d’un parc lisible, de sauvegardes testées, de mises à jour maîtrisées, d’une maintenance régulière et d’un journal d’incidents que quelqu’un exploite vraiment.
La priorité est claire : commencez par les pannes qui reviennent et qui bloquent le plus l’activité. Traitez la cause, documentez la solution, puis vérifiez que le problème baisse réellement. C’est cette discipline, plus que le dépannage en urgence, qui rend un SI de PME plus stable.
Ces sources cadrent les bonnes pratiques générales. Elles ne remplacent pas un audit de votre système d’information, de vos contrats ou de vos obligations métiers.
Référentiel public utile pour cadrer les pratiques de base: inventaire, mises à jour, sauvegardes, droits et maîtrise du SI.
ConsulterRepères pratiques pour organiser des sauvegardes et éviter qu’une panne ou un incident ne devienne une perte durable.
ConsulterRappels sur l’importance des mises à jour et du maintien des logiciels et équipements dans un état maîtrisé.
ConsulterFiche de sécurité sur les sauvegardes, la restauration et la continuité d’activité.
Consulter