Conteneur applicatif
Exécuter une brique
API, front-end, worker, base locale ou outil technique isolé.

Logiciels Services
Une application client container n’est pas un label magique à coller sur n’importe quel projet. Elle devient utile quand une équipe doit faire tourner la même application, avec les mêmes dépendances, sur un poste de développement, une intégration continue, un environnement de recette ou une production. Le conteneur sert alors à stabiliser l’environnement d’exécution, pas à masquer une architecture mal cadrée ou une chaîne de livraison déjà confuse.
Pour une PME ou une équipe produit, la bonne question n’est donc pas “faut-il tout mettre dans Docker ?”. La question plus concrète est : quels écarts entre machines, versions, secrets, ports et services ralentissent déjà le travail ? Si ces écarts provoquent des incidents, des installations longues ou des livraisons fragiles, la conteneurisation peut apporter un vrai gain, surtout lorsque plusieurs profils interviennent sur le même périmètre.
Le conteneur doit résoudre un problème observable, sinon il ajoute seulement une couche de plus. Techniquement, il exécute un processus isolé avec les fichiers dont il a besoin. Dans un projet web courant, cela peut séparer le front-end, l’API, la base de données, un worker ou un outil de build. Le bénéfice est simple : chaque brique garde son runtime et ses dépendances au lieu de dépendre de ce qui est installé sur la machine de chacun.
Cette approche réduit le classique “ça marche sur mon poste”. Elle ne supprime pas les bugs, mais elle limite une catégorie entière de problèmes : versions de Node ou Python différentes, extension système manquante, base locale mal initialisée, port déjà occupé, ou service oublié au démarrage. Pour un usage client, la stabilité du poste devient aussi importante que la stabilité du serveur.
Il faut toutefois rester précis sur le vocabulaire. Une application “client container” peut désigner un outil utilisé côté poste, un environnement de développement complet, un client technique qui consomme des API, ou une application packagée pour un déploiement interne. Dans tous les cas, le conteneur n’est pas le produit final : c’est le cadre d’exécution.
Le gain devient visible quand ce cadre d’exécution remplace une installation fragile. Dans une équipe qui maintient plusieurs applications, la matrice des versions finit souvent par prendre plus de temps que le code : une version de Java pour un outil, une version de Node pour un front, une base locale mal initialisée, un cache lancé à la main. Un conteneur ne rend pas tout simple, mais il rend ces choix explicites.
Cette clarté aide aussi les profils non spécialistes. Un chef de projet technique, un prestataire ou un développeur qui rejoint le projet n’a pas besoin de deviner l’environnement attendu. Il lit la configuration, lance la stack et voit plus vite si le problème vient du code, de la donnée ou de l’infrastructure. La reproductibilité devient alors un outil de diagnostic.
| Situation | Conteneur utile ? | Pourquoi |
|---|---|---|
| Une application avec API, base et worker local | Oui | Compose peut démarrer tout l’écosystème en une commande. |
| Un simple script sans dépendance externe | Pas toujours | Le conteneur peut ajouter plus de friction que de valeur. |
| Une équipe qui change souvent de poste ou de prestataire | Oui | L’onboarding devient plus court et plus contrôlable. |
| Une charge exigeant un OS complet différent | À étudier | Une machine virtuelle peut rester plus adaptée. |
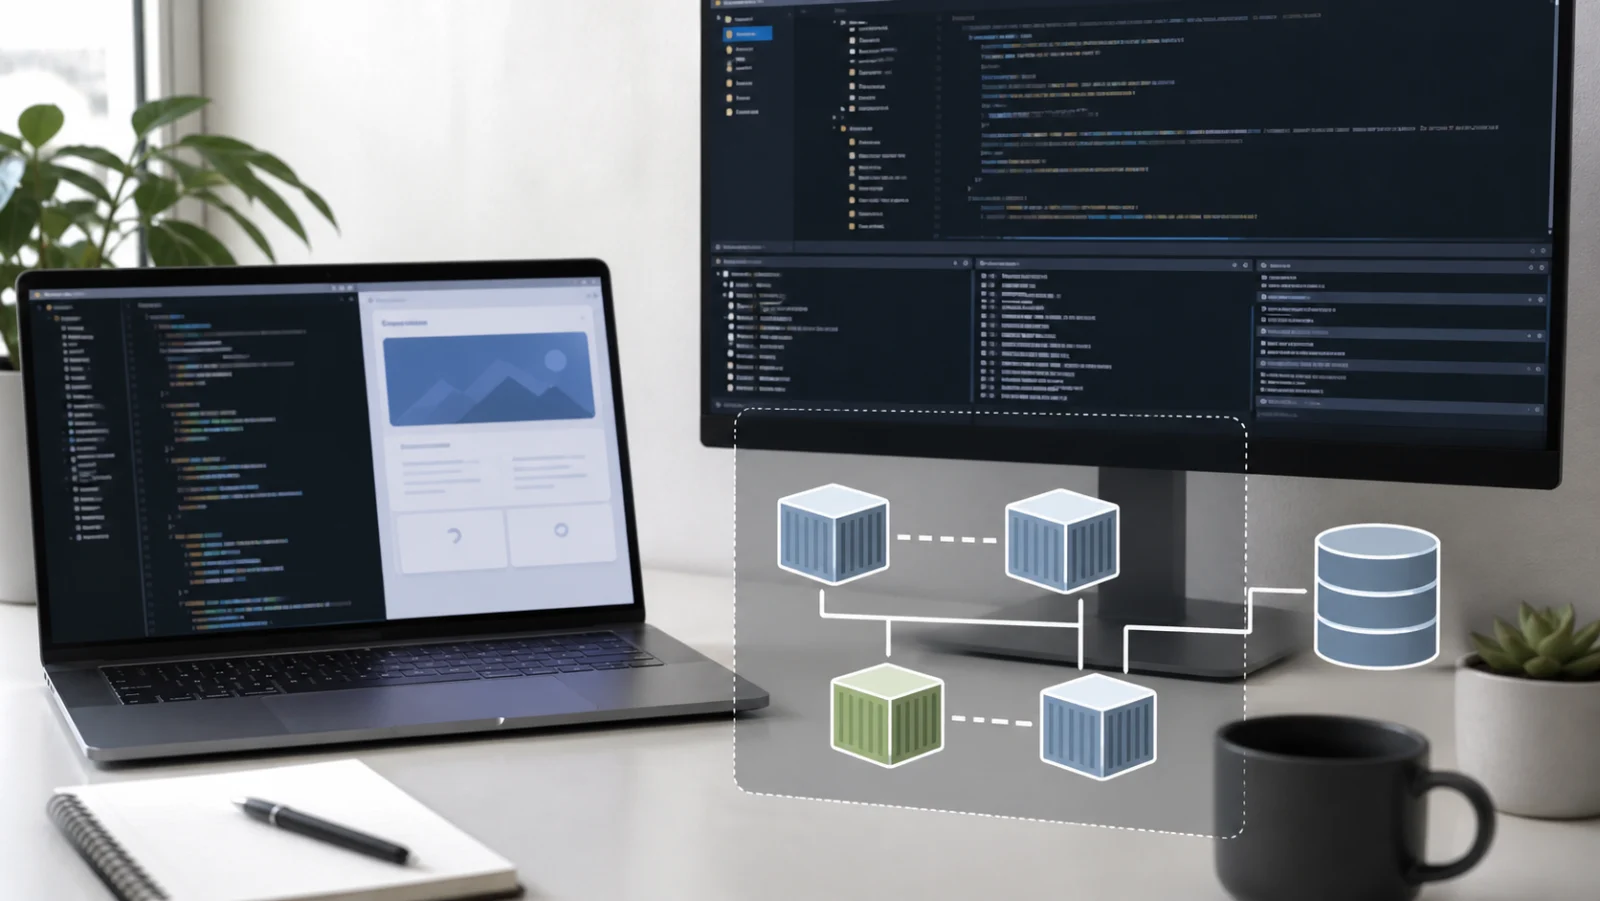
Le bon périmètre est souvent petit. Il permet de tester le gain sans déplacer toute la pile applicative d’un seul coup.
Le mauvais réflexe consiste à conteneuriser toute la stack d’un coup. Le départ le plus solide consiste plutôt à identifier le périmètre qui casse le plus souvent. Cela peut être une base PostgreSQL locale, un service de cache, un vieux runtime applicatif ou un outil de build que personne n’installe de la même manière.
Un conteneur doit remplacer une procédure fragile par une convention lisible. Si le projet a besoin de dix pages de consignes pour installer l’environnement local, un fichier de configuration partagé peut créer un vrai progrès. Si l’équipe maîtrise déjà un setup simple, stable et documenté, la priorité peut être ailleurs.
Les trois notions répondent à des problèmes différents.
Exécuter une brique
API, front-end, worker, base locale ou outil technique isolé.
Standardiser le poste
L’éditeur, les outils et le runtime suivent le projet pour faciliter l’onboarding.
Démarrer plusieurs services
Utile pour une stack locale ou une CI avec réseau et volumes déclarés.
Orchestrer en production
Pertinent pour résilience, scheduling, déploiements et exploitation à l’échelle.
Cette séparation évite les décisions trop lourdes. Une équipe peut adopter un dev container sans déployer sur Kubernetes. Elle peut utiliser Docker Compose pour la recette sans faire de microservices. Elle peut aussi garder une production classique et conteneuriser seulement les outils de build. Le niveau choisi doit répondre au problème observé, pas à une mode technique.
Pour approfondir ce point, consultez sumatra pdf, qui traite plus précisément de utiliser sumatra pdf en pme quand le besoin reste simple.
Le périmètre doit aussi tenir compte des personnes qui vont maintenir la solution. Un environnement conteneurisé compris par deux développeurs seulement reste fragile. Il faut donc prévoir une documentation minimale : comment démarrer, comment arrêter proprement, comment réinitialiser les volumes, comment lire les logs et comment mettre à jour l’image de base. Ces gestes simples évitent que le conteneur devienne une boîte noire au prochain départ, audit ou changement de prestataire.
Un bon test consiste à confier le projet à quelqu’un qui ne l’a jamais lancé. S’il peut démarrer l’application, charger des données de test et exécuter la suite de contrôle sans assistance longue, le conteneur apporte de la valeur. S’il doit contourner les scripts ou modifier la configuration locale dès le premier jour, la promesse d’onboarding n’est pas encore tenue.
Un bon conteneur est explicite. Il décrit l’image de base, les dépendances, les ports, les variables attendues, les volumes nécessaires et les commandes de démarrage. Cette description devient une documentation exécutable, mais elle doit rester lisible par les personnes qui vont intervenir dessus dans six mois. Elle n’empêche pas les développeurs de comprendre le système ; elle leur donne au contraire un point de départ commun, avec des choix visibles au lieu d’une installation transmise oralement.
Pour les applications composées de plusieurs services, Docker Compose reste souvent le bon premier outil. La configuration YAML permet de déclarer services, réseaux et volumes, puis de démarrer l’ensemble avec une commande. C’est suffisant pour beaucoup d’équipes qui veulent aligner développement, test et CI sans administrer une plateforme complète.
Le dev container ajoute une couche intéressante quand le poste lui-même devient une source de variabilité. Avec VS Code Dev Containers, le projet peut indiquer comment ouvrir un dossier dans un environnement équipé du bon runtime, des bons outils et des extensions nécessaires. L’objectif n’est pas de verrouiller chaque habitude, mais de rendre l’environnement critique disponible rapidement.
La limite à poser dès le départ concerne les données. Les conteneurs sont éphémères par nature : on doit pouvoir les supprimer et les recréer. Les fichiers persistants, bases locales, caches utiles ou jeux de données doivent donc être traités volontairement, avec des volumes, des dumps de test et une procédure de reset. Sinon, la donnée locale devient plus difficile à comprendre qu’avant.
Il faut également séparer les paramètres qui appartiennent au projet et ceux qui appartiennent à chaque environnement. Une URL interne, un mode debug ou un port local peuvent être documentés. Un mot de passe, une clé API ou un token ne doit pas finir dans l’image. Cette discipline paraît basique, mais elle évite les fuites, facilite la rotation et rend la configuration sensible plus simple à auditer lors d’un incident.
Avant de conteneuriser, vérifiez que le gain est mesurable.
Un nouveau poste démarre-t-il en moins d’une heure ?
Impact décision : Sinon, un environnement conteneurisé peut réduire la dépendance aux consignes manuelles.
Les incidents viennent-ils souvent des versions locales ?
Impact décision : C’est un bon signal pour isoler runtime et dépendances.
L’équipe sait-elle maintenir les images ?
Impact décision : Sans mise à jour régulière, le conteneur devient une dette de sécurité.
Peut-on revenir à l’ancien mode en cas de blocage ?
Impact décision : Un plan de retour arrière évite de transformer un essai en migration subie.
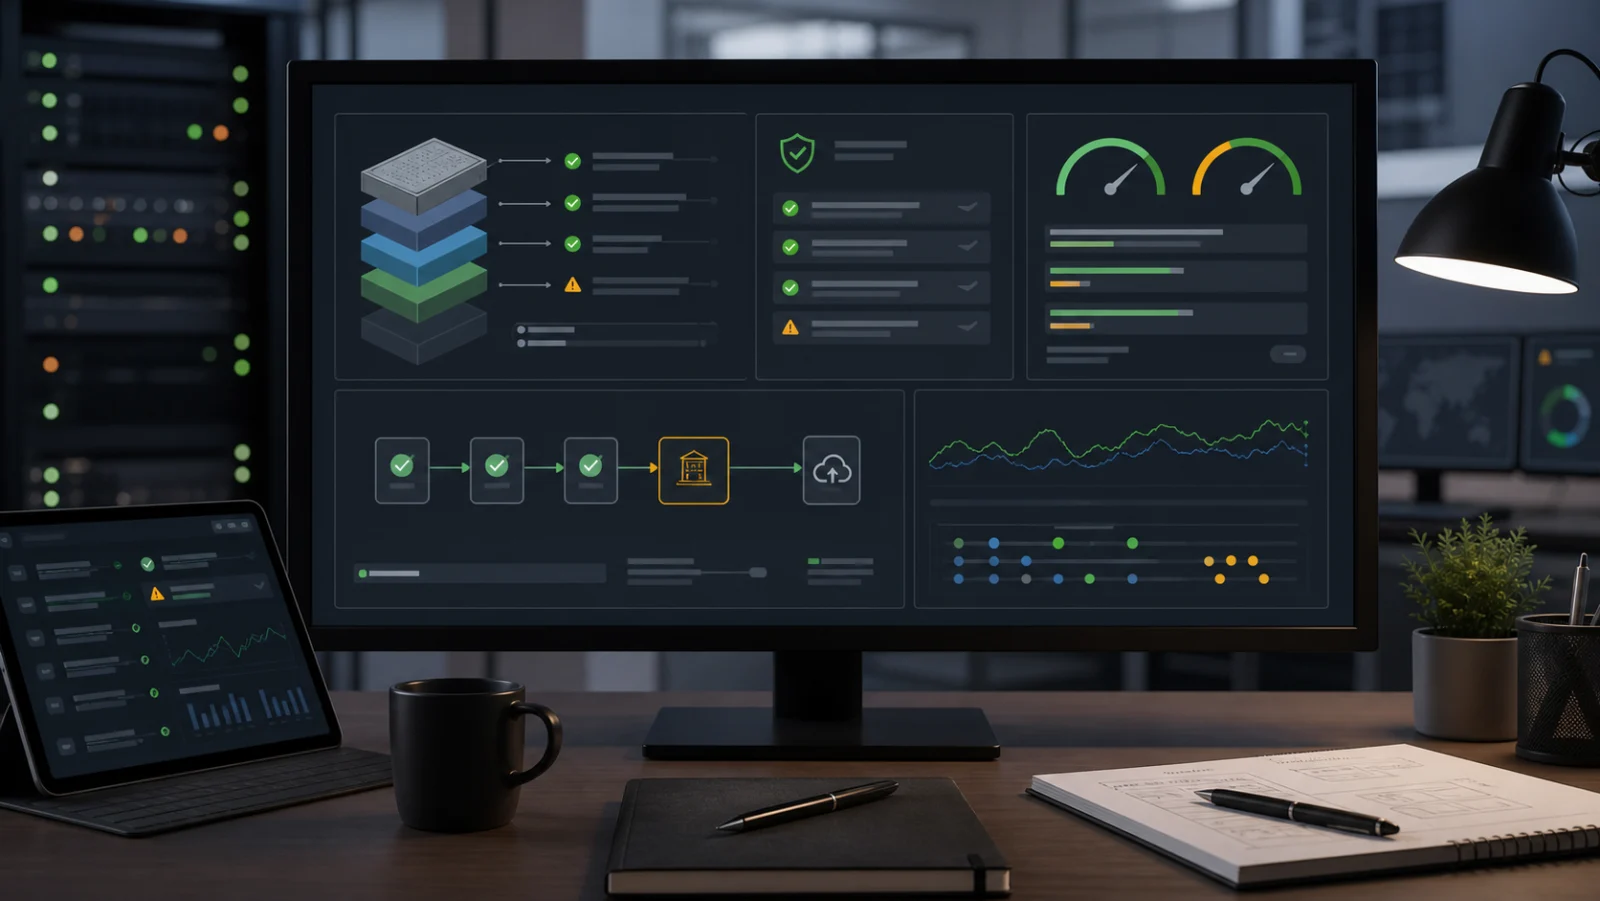
L’isolation ne dispense pas de gouvernance. Un conteneur donne une impression de séparation, mais il n’est pas une boîte invulnérable. L’image de base peut contenir des failles, les dépendances vieillissent, les secrets peuvent être copiés par erreur et un processus trop permissif peut exposer l’hôte. Pour une équipe sérieuse, la sécurité des images fait partie du cycle de livraison.
Le minimum consiste à choisir des images maintenues, réduire les paquets inutiles, scanner les vulnérabilités, fixer les versions importantes et reconstruire régulièrement. Les secrets ne doivent jamais être inscrits dans le Dockerfile ni dans l’image. Ils doivent venir d’un coffre, d’un secret manager, d’une variable injectée par l’environnement ou d’un mécanisme équivalent.
Les coûts se jouent aussi dans des détails très concrets. Une image trop lourde ralentit les pulls, encombre les registres et allonge les déploiements. Des limites CPU/mémoire absentes peuvent provoquer de la contention. À l’inverse, des limites trop basses créent des erreurs difficiles à diagnostiquer. Il faut donc définir des limites de ressources, mesurer, puis ajuster.
La maintenance des images mérite un propriétaire clair. Sans responsable, les Dockerfiles vieillissent, les dépendances restent figées et les contournements s’accumulent. La bonne pratique consiste à intégrer la reconstruction régulière dans la CI, à conserver un historique des images publiées et à vérifier que l’équipe sait revenir à une version précédente en cas d’incident.
Avant de considérer l’approche comme prête, validez ces points.
À quel moment l’orchestration devient-elle utile ? Quand le problème n’est plus seulement de lancer un conteneur, mais d’exploiter plusieurs services avec redémarrage, déploiement progressif, découverte réseau et surveillance. Kubernetes apporte des pods, du scheduling, du redémarrage automatique, des services et une base solide pour opérer plusieurs applications. C’est puissant, mais ce n’est pas gratuit en complexité.
Si l’équipe cherche seulement à démarrer une API, une base et un front-end sur un poste, Kubernetes est probablement trop lourd. Cette limite mérite d’être assumée dès le cadrage.
Il devient pertinent quand plusieurs services doivent être exploités avec des besoins réels de résilience, de scaling, de séparation réseau, de déploiements contrôlés et de surveillance. Le passage doit s’accompagner de pratiques d’exploitation : logs centralisés, métriques, alertes, droits, politiques réseau et procédures d’incident. Sans cela, l’orchestrateur ajoute une couche opaque au lieu de clarifier.
Dans beaucoup de PME, la trajectoire raisonnable est progressive : Dockerfile propre, Compose pour le local, CI qui construit et teste, registre maîtrisé, puis orchestration seulement si les symptômes le justifient. Ce chemin donne de la valeur à chaque étape et évite de payer trop tôt le coût d’une plateforme complète.
Le signal d’alerte le plus fréquent est organisationnel : l’équipe parle davantage de clusters, de charts et d’outils que du problème initial. Si le besoin était seulement de lancer une stack locale fiable, l’orchestration complète n’apporte pas encore assez de valeur. À l’inverse, si plusieurs services doivent être déployés souvent avec rollback, montée en charge et surveillance, rester sur des scripts manuels devient risqué et coûteux à sécuriser.
La dette apparaît quand le conteneur devient intouchable. La première erreur consiste à copier un Dockerfile trouvé ailleurs sans comprendre ses couches. Une image de base trop large, des paquets installés sans nettoyage ou un utilisateur root par défaut créent une dette discrète. Au début, tout démarre. Quelques mois plus tard, la surface d’attaque et le temps de build deviennent difficiles à réduire.
La deuxième erreur est de confondre reproductibilité et rigidité. Un conteneur doit standardiser ce qui compte : runtime, dépendances, services voisins, commandes de test. Il ne doit pas empêcher l’équipe d’inspecter, déboguer ou faire évoluer l’application. Si chaque modification demande une intervention d’architecture, le cadre technique est trop lourd pour le besoin.
La troisième erreur est de traiter le conteneur comme une documentation suffisante. Le fichier de configuration aide, mais il ne remplace pas les décisions écrites : pourquoi ce runtime, pourquoi ce port, pourquoi ce volume, pourquoi cette limite mémoire. Ces explications courtes évitent que la prochaine personne conserve une mauvaise hypothèse par prudence, surtout lorsque le projet change de prestataire ou repart après plusieurs mois sans évolution et que les choix initiaux ne sont plus évidents.
La logique reste banale. Moins de dépendances, moins de privilèges, moins d’implicite, et une image que l’équipe comprend.
Décidez avec un cas réel. Une préférence d’outillage ne suffit pas à justifier une migration d’équipe. Le test doit rester factuel.
Commencez par un seul flux critique. Prenez une application qui pose un problème concret : installation trop longue, dépendances instables, recette difficile à reproduire ou prestataire qui perd du temps à préparer son poste. Définissez ensuite un objectif mesurable, par exemple réduire l’onboarding, fiabiliser la CI ou rendre un environnement de test reproductible avant tout déploiement plus large. Le conteneur doit prouver son utilité dans ce flux avant de devenir une règle d’équipe.
Ensuite, livrez une version minimale : un Dockerfile clair, un Compose si plusieurs services sont nécessaires, un README court et une vérification automatique. Ne cherchez pas la plateforme parfaite au premier essai. Cherchez une boucle fiable que l’équipe peut comprendre, maintenir et abandonner si elle ne tient pas ses promesses.
Cette boucle doit inclure une mesure avant/après. Combien de temps prenait l’installation ? Combien d’incidents venaient des versions locales ? Combien d’étapes manuelles restaient nécessaires avant de lancer les tests ? Sans ces repères, la décision technique se juge à l’impression. Avec eux, l’équipe sait si le conteneur a vraiment simplifié le quotidien.
La recommandation est nette : conteneurisez quand cela réduit une variabilité déjà coûteuse. Sinon, gardez l’énergie pour le produit.
Virtual switch : optimiser le réseau des machines virtuelles fait l'objet d'un décryptage dédié dans Virtual switch : optimiser le réseau des.
Ces références servent à vérifier les notions de conteneur, Compose, dev container et pod Kubernetes.
Définition officielle du conteneur, différences avec les machines virtuelles et logique d’isolation.
ConsulterPrésentation officielle de Compose pour définir et lancer des applications multi-conteneurs.
ConsulterDocumentation officielle sur l’usage d’un conteneur comme environnement de développement.
ConsulterRéférence officielle sur l’unité de base d’exécution dans Kubernetes.
Consulter
À lire aussi

PDF-XChange Editor peut remplacer un simple lecteur PDF quand il faut annoter, modifier, OCRiser ou traiter des formulaires, à condition de vérifier les fonctions sous licence.

Un PDF joiner fusionne plusieurs fichiers, mais le bon choix dépend surtout de la confidentialité, de l'ordre des pages et du contrôle final.
Guide pratique pour comprendre Safari on Windows, eviter les anciens installateurs et choisir une methode de test Safari ou WebKit fiable.

Steam fonctionne sur Linux, mais l'expérience dépend surtout du jeu, de Proton, des pilotes graphiques et de la distribution utilisée.

PDFsam peut être utile quand il faut organiser des PDF en local, mais il ne remplace pas tous les éditeurs PDF.

Un PDF se modifie en ligne pour des corrections simples, mais pas pour tous les documents ni tous les usages sensibles.