ping
Disponibilité et latence simple
Utile pour vérifier une réponse globale, mais ne montre pas le chemin.

Informatique
Traceroute sous Linux sert à répondre à une question simple : par où passe réellement un paquet avant d’atteindre une machine distante ? Quand une application répond lentement, qu’un site semble inaccessible ou qu’un tunnel réseau se comporte bizarrement, cette commande aide à distinguer un problème local, un saut intermédiaire instable ou une destination qui ne répond plus.
Il faut pourtant l’utiliser avec méthode. Traceroute ne donne pas une vérité absolue sur Internet, et chaque ligne ne doit pas être lue comme une preuve définitive. L’outil montre une observation à un instant donné, avec des paquets de test, des délais et parfois des silences normaux. Bien interprété, il devient un excellent point de départ pour diagnostiquer un trajet réseau.
Traceroute envoie une série de paquets vers une destination en augmentant progressivement leur durée de vie réseau. À chaque étape, un équipement intermédiaire peut répondre et révéler un saut du chemin. Le résultat affiche donc une suite de lignes : passerelle locale, routeurs opérateur, réseaux de transit, hébergeur, puis destination si elle répond.
Dans un contexte d’administration Linux, l’intérêt n’est pas seulement de “voir la route”. Il s’agit surtout de comprendre où le symptôme commence. Si la latence apparaît dès la passerelle locale, on regarde le LAN, le Wi-Fi, le VPN ou le pare-feu interne. Si elle apparaît plus loin, on examine le fournisseur d’accès, le réseau de transit ou l’hébergeur. Si tout semble correct mais que l’application reste lente, le problème peut être applicatif plutôt que réseau.
Cette lecture évite de perdre du temps sur le mauvais périmètre, surtout quand plusieurs équipes se renvoient l’incident.
Sur certaines distributions, la commande n’est pas installée par défaut. Le paquet s’appelle généralement traceroute. Sur Debian ou Ubuntu, on l’installe souvent avec sudo apt install traceroute. Sur Fedora, la logique passe par sudo dnf install traceroute. Sur Arch, on le récupère via pacman. Le nom peut varier légèrement selon les dépôts, mais l’idée reste la même : installer l’outil de diagnostic, puis lancer un test vers un nom de domaine ou une adresse IP.
Une commande de base ressemble à traceroute example.com. Pour éviter que la résolution DNS ne ralentisse ou ne brouille la lecture, beaucoup d’administrateurs ajoutent -n, ce qui affiche les adresses IP sans chercher les noms. C’est souvent plus lisible en incident, car la résolution inverse peut ajouter du bruit.
Le bon réflexe consiste à noter exactement la commande utilisée. Deux traceroute lancés avec des options différentes ne racontent pas forcément la même chose.
En incident, la reproductibilité vaut souvent plus qu’une sortie spectaculaire mais impossible à comparer.
Pour approfondir ce point, consultez league of legends linux, qui traite plus précisément de league of legends sur linux, pourquoi ça bloque encore.
Chaque ligne correspond à un TTL, donc à une étape potentielle du trajet. Traceroute affiche généralement trois mesures par saut. Ces mesures donnent une idée du délai aller-retour entre votre machine et l’équipement qui répond. Une variation modérée est normale, surtout sur Internet. Un saut très lent peut attirer l’attention, mais il ne suffit pas à lui seul à prouver que le routeur est responsable.
Pourquoi ? Parce qu’un routeur peut traiter les paquets de transit rapidement tout en répondant lentement aux paquets de diagnostic. Autrement dit, il peut faire passer le trafic sans problème et limiter ses réponses ICMP ou UDP. C’est une nuance capitale : un saut lent isolé n’est pas forcément le goulot d’étranglement.
Ce qui compte davantage, c’est la continuité du symptôme. Si une hausse de latence apparaît à un saut et reste visible sur tous les sauts suivants, l’indice devient plus sérieux. Si une ligne affiche un délai élevé mais que les lignes suivantes redeviennent normales, le routeur a probablement simplement répondu lentement au diagnostic.
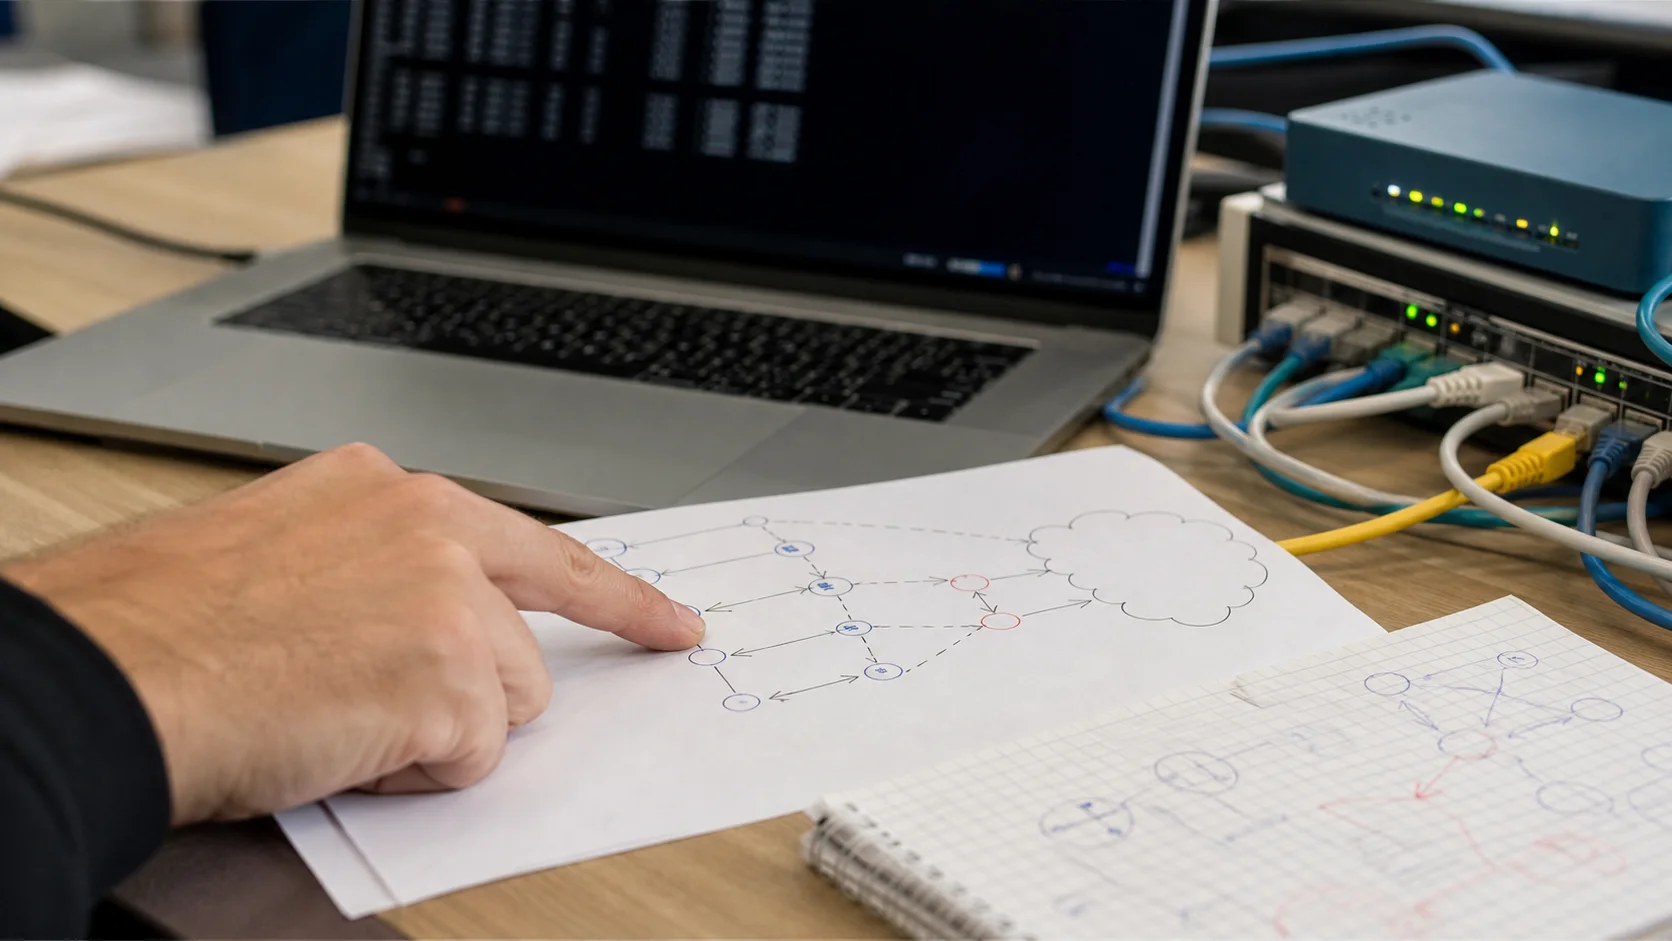
Les étoiles indiquent que traceroute n’a pas reçu de réponse exploitable pour une mesure donnée. Cela peut venir d’un filtrage, d’une limitation de débit, d’un pare-feu, d’un routeur configuré pour ne pas répondre ou d’une vraie perte. Le piège serait de traduire automatiquement * * * par “routeur en panne”. Dans beaucoup de réseaux, le silence ICMP est volontaire.
La distinction se fait par comparaison. Si un saut ne répond pas mais que les sauts suivants répondent, le trafic continue : l’équipement muet n’empêche pas forcément le passage. Si les étoiles apparaissent à partir d’un point et persistent jusqu’à la fin, la destination ou un segment du chemin peut être bloqué. Là encore, il faut vérifier avec un ping, un test TCP ou une connexion applicative.
Sur un réseau d’entreprise, les pare-feu rendent cette lecture encore plus délicate. Un traceroute peut échouer alors qu’un flux HTTPS fonctionne parfaitement, parce que les politiques filtrent les paquets de diagnostic mais autorisent le port applicatif attendu.
Selon les systèmes et les options, traceroute peut utiliser UDP, ICMP ou TCP. Cette différence explique pourquoi deux tests vers la même destination donnent parfois des résultats différents. Un chemin peut filtrer l’UDP de diagnostic, laisser passer l’ICMP, ou autoriser seulement certains ports TCP. Pour un diagnostic professionnel, le protocole de test doit se rapprocher du flux qui pose problème.
Si une application web répond mal, un traceroute TCP vers le port 443 peut être plus parlant qu’un traceroute UDP classique, à condition d’avoir l’outil ou l’option adaptée. Si vous vérifiez une connectivité générale, ICMP ou UDP peut suffire. Si vous travaillez derrière un pare-feu strict, tester plusieurs modes évite de confondre filtrage de diagnostic et panne réseau.
Traceroute est rarement seul dans un diagnostic réseau sérieux.
Disponibilité et latence simple
Utile pour vérifier une réponse globale, mais ne montre pas le chemin.
Chemin et sauts intermédiaires
Aide à localiser où un symptôme apparaît sur la route.
Suivi continu
Pratique pour observer pertes et latence sur plusieurs minutes.
Test applicatif
Permet de vérifier le port et le service réellement concernés.
Supposons qu’une application SaaS devienne lente depuis un bureau, alors qu’elle reste correcte depuis une connexion mobile. Le premier test consiste à vérifier la résolution DNS, puis à lancer un ping court vers la destination ou son IP. Ensuite, traceroute permet de voir si la latence augmente dès le routeur local, à la sortie opérateur ou plus loin chez un transit.
Si le problème apparaît uniquement depuis le bureau, comparez avec une autre machine du même réseau. Si les deux donnent le même résultat, regardez la passerelle, le VPN, le proxy ou le fournisseur d’accès. Si une seule machine est touchée, le diagnostic se recentre sur son poste : configuration DNS, route locale, client VPN, sécurité endpoint ou pile réseau. Le périmètre d’investigation change avec cette simple comparaison.
Dans un environnement multi-sites, il faut répéter le test depuis plusieurs points. Un traceroute depuis le siège, une agence et un serveur cloud peut révéler un problème de peering, un chemin asymétrique ou une politique de routage différente.
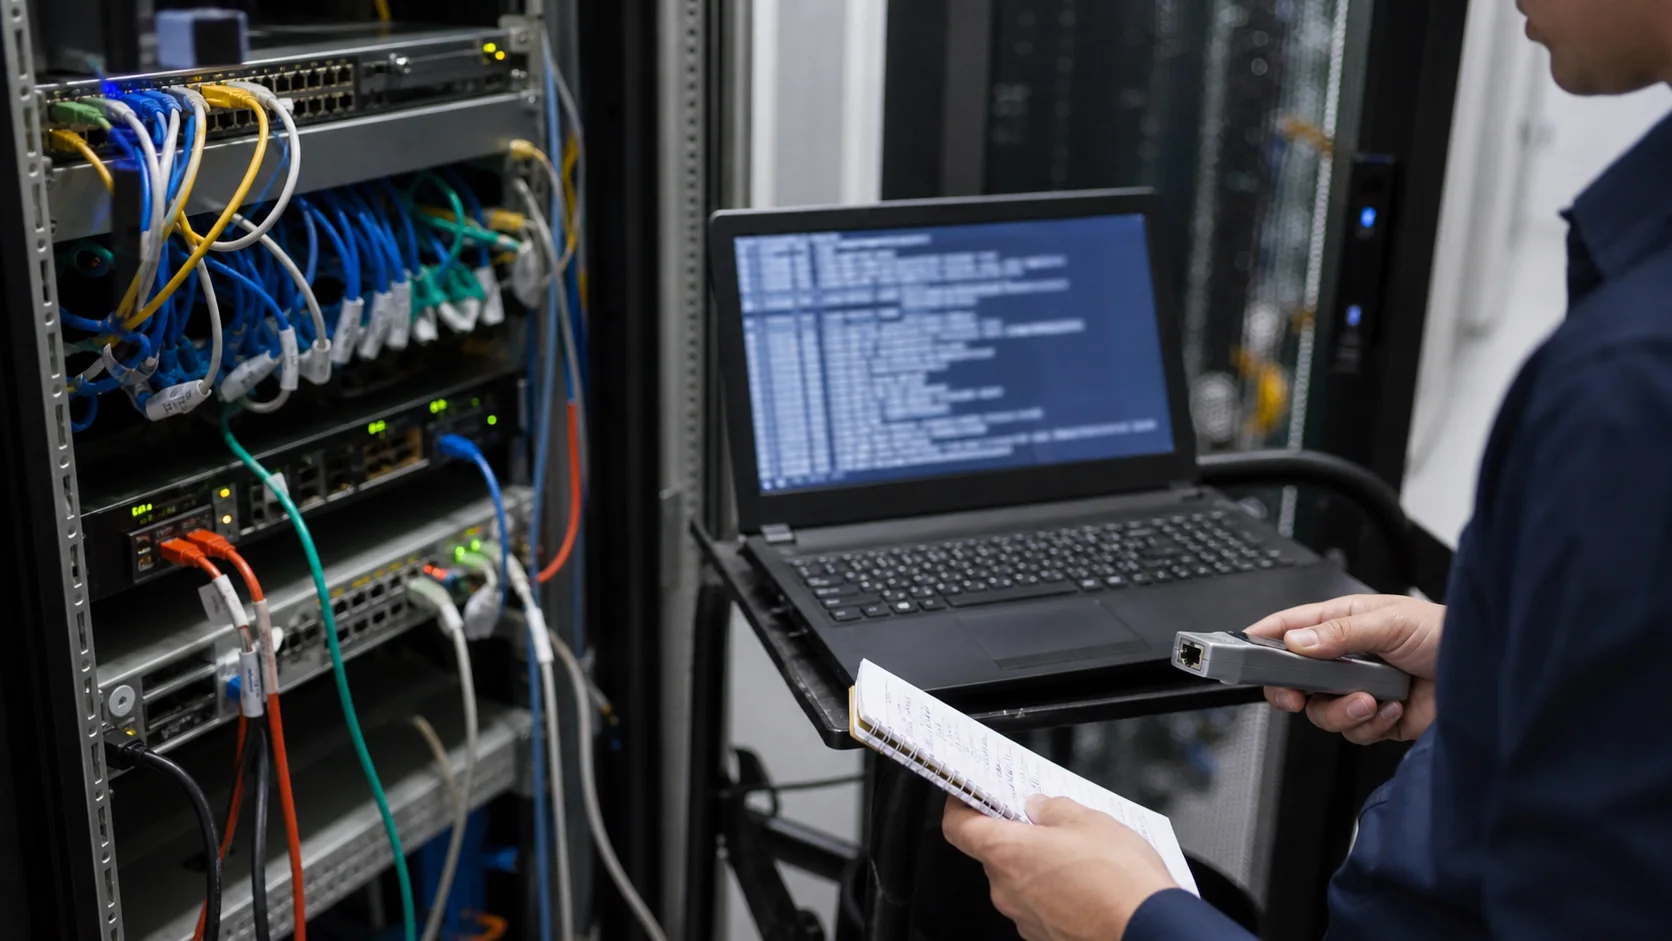
Traceroute observe le chemin aller apparent, pas toujours le chemin retour. Or, sur Internet et dans les réseaux complexes, le trafic peut être asymétrique. La réponse peut revenir par une autre route, ce qui complique l’analyse des délais. C’est une raison de plus pour croiser les outils et multiplier les points de mesure.
Autre limite : les chemins peuvent changer entre deux tests. Les opérateurs équilibrent la charge, déplacent les routes, filtrent certains paquets et appliquent des politiques différentes selon les préfixes. Un résultat isolé vaut donc moins qu’une série courte, horodatée et comparable. La preuve terrain se construit avec plusieurs mesures cohérentes, pas avec une capture unique sortie de son contexte.
Enfin, traceroute ne dit rien de la couche applicative. Un chemin réseau propre ne garantit pas qu’un serveur web, une base de données, une API ou un certificat fonctionne correctement. Il indique seulement que le trajet réseau observé ne montre pas l’anomalie attendue.
Traceroute donne une photographie. mtr, lui, combine l’idée de traceroute et une mesure répétée, ce qui le rend utile pour les pertes intermittentes ou les latences qui montent par vagues. Sur un incident qui disparaît puis revient, mtr permet d’observer une tendance au lieu de relancer manuellement la commande toutes les trente secondes.
Il faut toutefois le lire avec les mêmes précautions. Les pertes affichées sur un saut intermédiaire peuvent être dues à une limitation de réponse, pas à une perte réelle pour le trafic de transit. Regardez surtout si les pertes se propagent jusqu’à la destination. Si seul un routeur intermédiaire “perd” des réponses mais que la destination reste propre, l’alerte est souvent moins grave qu’elle en a l’air.
Un bon diagnostic ne se limite pas à coller une sortie traceroute dans un ticket. Il explique le contexte : depuis quelle machine, vers quelle destination, à quelle heure, avec quelle connexion, après quel symptôme et avec quelles autres mesures. Ces informations permettent à un hébergeur, un opérateur ou une équipe réseau de comprendre plus vite ce que vous observez.
Ajoutez aussi ce que vous avez exclu. DNS vérifié, test depuis un autre réseau, application testée sur le port réel, VPN activé ou non, pare-feu local contrôlé : ces éléments évitent les allers-retours. Pour une DSI ou une équipe infrastructure, la valeur de traceroute vient autant de la commande que de la discipline autour de la mesure.
Machine source, réseau utilisé, VPN ou proxy, destination et service impacté.
Sorties ping, traceroute ou mtr, horodatées et répétées si le problème varie.
Résultat depuis un autre poste, un autre site ou une connexion externe.
Application touchée, fréquence, utilisateurs concernés et heure de début.
Utilisez traceroute comme un outil de cadrage, pas comme un juge unique. Il aide à localiser une zone probable, à documenter un symptôme et à orienter la suite du diagnostic. Quand il est croisé avec ping, mtr, DNS et un test applicatif, il devient très efficace pour séparer une impression de lenteur d’un problème réseau réellement observable.
La commande est simple. C’est son interprétation qui demande de la rigueur, et c’est là que le diagnostic gagne en crédibilité.
Pour approfondir ce point, consultez plus de réseau, qui traite plus précisément de diagnostiquer une panne réseau sans tout dérégler.
À lire aussi

Ubuntu Server est un bon choix pour héberger des services Linux stables, à condition de préparer la version LTS, l'accès SSH, les mises à jour, le pare-feu et les sauvegardes.
Recherchez-vous un équipement capable de vous aider dans la gestion de votre organisation? Les imprimantes de codes-barres occupent une place importante dans de nombreux secteurs. Elles permettent d'identifier rapidement les produits, colis.
Les vérifications à faire avant d'utiliser un outil de reconnaissance faciale, de recherche d'image visage ou d'analyse biométrique.

Un support utilisateur PME efficace ne repose pas seulement sur un outil de ticketing. Il clarifie les demandes, les priorités, les délais, l'escalade et la mémoire de résolution.

Sous Linux, supprimer un dossier dépend surtout de son contenu. Voici quelle commande choisir et les précautions à prendre avant une suppression récursive.

Les commandes Linux utiles ne se résument pas à une liste: il faut comprendre le contexte, les options et le risque avant d'exécuter.