Web
Hébergeur web, comprendre son rôle avant de choisir
Un hébergeur web ne se résume pas à louer de l'espace disque. Il porte la disponibilité, la sécurité, les sauvegardes et une partie de la performance du site.

Web
Un fichier wp robots txt sert a donner des consignes de crawl aux robots, pas a cacher une page sensible ni a la retirer de Google. Sur WordPress, la bonne configuration reste courte : laisser les ressources utiles accessibles, signaler le sitemap et bloquer seulement ce qui n'a pas vocation a etre explore.
Le point a retenir est simple : robots.txt agit avant le chargement d'une URL. Pour une page qui doit vraiment sortir de l'index, il faut raisonner avec noindex, canonique ou suppression, pas avec une interdiction de crawl placee au mauvais endroit.
Un fichier wp robots txt efficace indique aux crawlers ce qu'ils peuvent explorer sans les empecher de charger les fichiers utiles au rendu. Il peut bloquer des zones techniques, mais il ne doit pas fermer CSS, JavaScript, images ou pages publiques. Sa mission principale est d'organiser le crawl, pas de regler seul l'indexation.
Sur WordPress, la tentation classique consiste a copier un modele trouve ailleurs et a bloquer tout /wp-content/ ou tout /wp-includes/. C'est rarement une bonne idee. Les moteurs doivent pouvoir voir les fichiers de theme, scripts, feuilles de style et medias necessaires pour comprendre la page comme un utilisateur.
| Regle | Usage prudent | Risque si mal utilisee |
|---|---|---|
| User-agent: * | Appliquer une consigne generale a tous les robots | Trop large si le reste du fichier est agressif |
| Disallow: /wp-admin/ | Limiter l'exploration de l'administration | Ne doit pas bloquer admin-ajax.php |
| Allow: /wp-admin/admin-ajax.php | Preserver certaines fonctions front | Oubli possible sur themes ou plugins dynamiques |
| Sitemap: | Pointer vers le sitemap XML public | Ne corrige pas un sitemap vide ou faux |
| Disallow: /?s= | Limiter certaines pages de recherche interne | A adapter si la recherche interne est indexable volontairement |
Un exemple sobre peut ressembler a une base de travail : autoriser les ressources utiles, limiter l'administration et declarer le sitemap. Il faut ensuite l'adapter au site, car un WordPress vit avec des themes, extensions, langues, facettes ou espaces membres qui changent le besoin reel.
User-agent: *
Disallow: /wp-admin/
Allow: /wp-admin/admin-ajax.php
Disallow: /?s=
Sitemap: https://exemple.fr/sitemap_index.xml
Ce bloc n'est pas une regle universelle. Une boutique, un site d'annonces, un intranet partiel ou un magazine avec filtres peut demander un arbitrage different. Le bon reflexe consiste a documenter chaque ligne : quelle URL vise-t-elle, pourquoi, et que se passe-t-il si Google ne peut plus la crawler ?
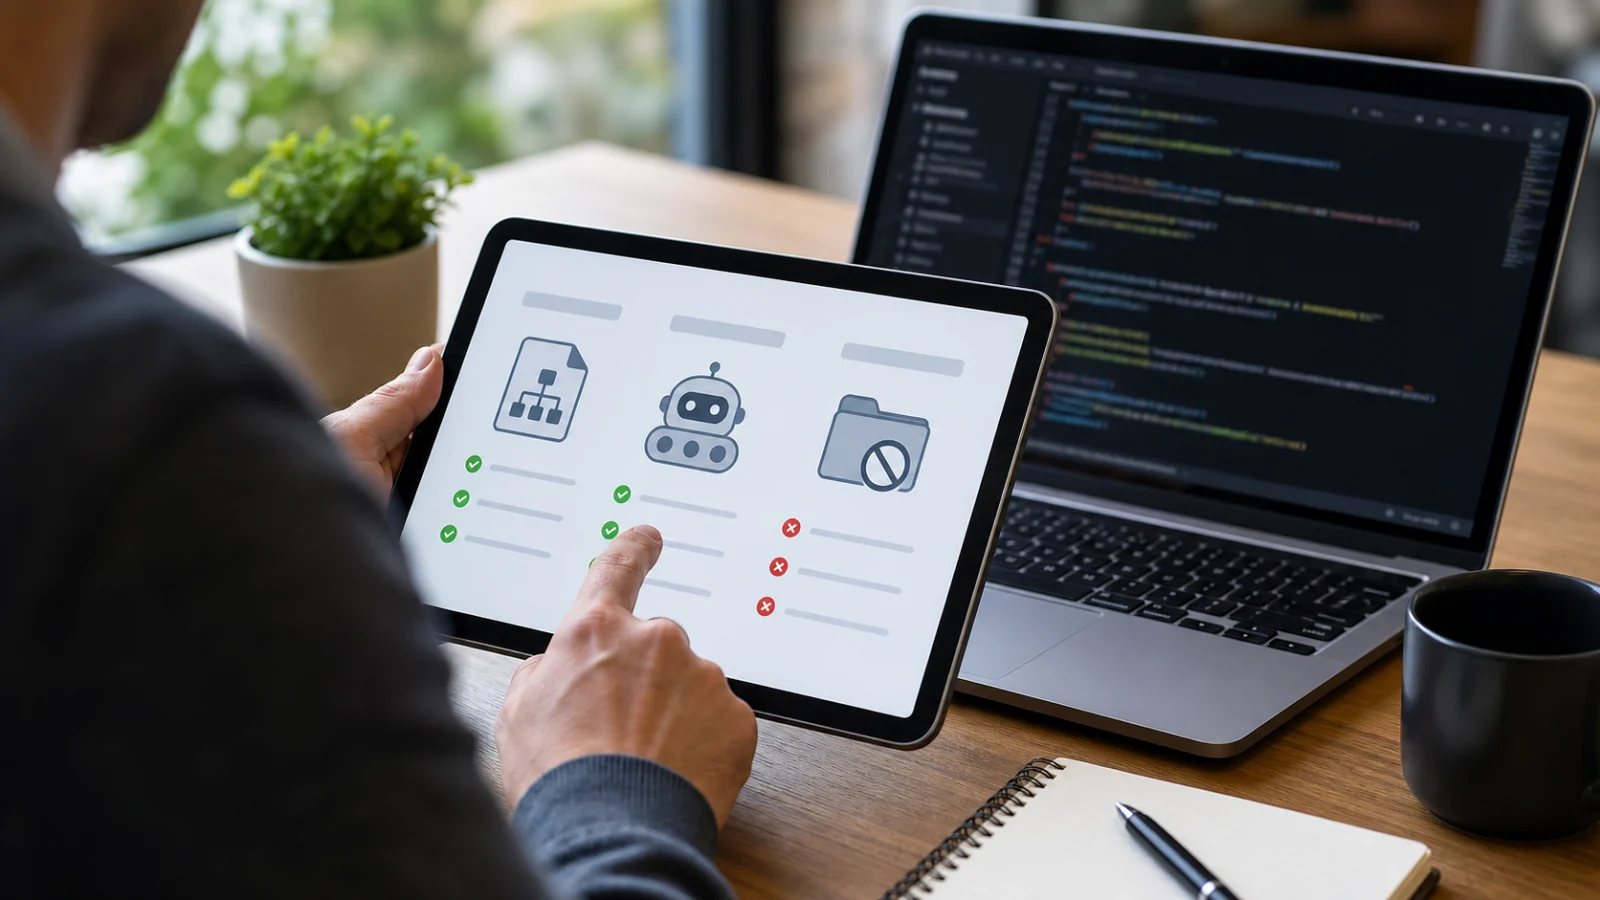
Avant toute mise en ligne, controlez le rendu d'une page importante. Si un test de page montre que les styles ou scripts ne chargent plus, la directive est trop large. Une consigne robots.txt peut paraitre propre dans un fichier, mais produire une page mal interpretee par les moteurs.
La confusion la plus couteuse vient du mot "bloquer". Bloquer le crawl ne signifie pas toujours retirer une URL de l'index. Si une page est deja connue, Google peut conserver une URL sans pouvoir lire son contenu, surtout si d'autres pages la citent. Pour une desindexation volontaire, noindex doit etre accessible au crawl.
Le sitemap, lui, sert a signaler les URL importantes. Il ne force pas leur indexation et ne compense pas un mauvais robots.txt. Une page presente dans le sitemap mais interdite au crawl envoie un signal contradictoire. C'est souvent le symptome d'une configuration melangee entre extension SEO, cache et regles serveur.
Un site WordPress propre combine ces outils au lieu d'en charger un seul de tout faire. Par exemple, une page de resultat de recherche interne peut etre exclue du sitemap, parfois bloquee au crawl, tandis qu'une page archive proche d'une categorie principale peut plutot demander une canonique ou un noindex selon le cas.
Avant de considerer le fichier pret, ouvrez l'URL exacte /robots.txt dans le navigateur, puis testez quelques pages importantes : accueil, article, categorie, page avec medias, page generee par un plugin critique. L'objectif est de repérer une directive trop large avant qu'elle ne reduise l'exploration utile.
Verifiez ensuite que le fichier publie correspond bien a celui attendu. WordPress peut generer un robots.txt virtuel, mais un fichier physique, une regle serveur, une extension SEO ou un cache peuvent prendre le dessus. Dans un diagnostic, il faut donc regarder la version servie publiquement, pas seulement l'ecran de configuration.
Bloquer /wp-admin/ est courant, mais l'administration doit de toute facon etre protegee par authentification et securite applicative. La ligne robots.txt n'est pas une mesure de protection. Elle sert seulement a eviter un crawl inutile, en laissant accessibles les ressources front qui en dependent.
Non. Une page privee doit etre protegee par controle d'acces, mot de passe, authentification ou retrait reel. robots.txt est public et consultable. Il peut meme signaler l'existence d'une zone. Pour une URL confidentielle, ne comptez jamais sur robots.txt comme barriere.
Modifiez-le apres un changement structurel : nouveau plugin SEO, migration, refonte des URL, ajout de facettes, espace membre ou probleme de crawl identifie. Pour un site vitrine simple, un fichier minimal et stable vaut souvent mieux qu'une longue liste de dossiers bloques sans justification.
Le bon wp robots txt est donc celui que vous pouvez expliquer ligne par ligne. Court, teste et coherent avec le sitemap, il aide les moteurs sans masquer les contenus utiles ni créer une fausse impression de desindexation.
À lire aussi
Un hébergeur web ne se résume pas à louer de l'espace disque. Il porte la disponibilité, la sécurité, les sauvegardes et une partie de la performance du site.

Un guide clair pour distinguer cookies utiles, traceurs tiers, consentement, sécurité de session et réglages efficaces dans son navigateur.

Un guide clair pour lire la structure d'une URL, comprendre son rôle dans le web et repérer les liens douteux avant de cliquer.

Tous les réseaux sociaux ne servent pas le même objectif. Pour une PME, le bon choix consiste à relier audience, format, capacité interne et indicateurs business, plutôt qu'à ouvrir un compte sur chaque plateforme visible.
Regedit Windows 10: méthode prudente pour ouvrir l'Éditeur du Registre, exporter une clé, restaurer une sauvegarde et comprendre RegBack.
Réparer Photos, rétablir les associations et comprendre Windows Photo Viewer.