Décision
Nom
Le nom décrit-il clairement son usage ?
Impact décision : Réduit les confusions entre équipes.


Informatique
Une application qui fonctionne en local mais tombe en erreur après déploiement souffre souvent du même problème : sa configuration n’est pas maîtrisée. Une URL de base de données, un mode debug, un jeton API ou un niveau de log a été laissé au mauvais endroit. Les variables d’environnement servent précisément à éviter cette confusion, surtout quand plusieurs personnes interviennent sur le même projet et que les habitudes locales ne sont plus visibles.
Elles ne rendent pas une application magique ni automatiquement sécurisée. Elles donnent un cadre : le code reste stable, tandis que les valeurs changent selon la machine, le conteneur, l’équipe ou l’environnement de production. Bien utilisées, elles réduisent les commits risqués, les secrets exposés et les déploiements bricolés, sans demander de réécrire l’application à chaque changement d’infrastructure.
Le vrai sujet n’est donc pas la syntaxe. C’est la maîtrise du contexte d’exécution, avant de choisir où stocker vos valeurs sensibles.
Une variable d’environnement est une paire nom/valeur disponible pour un processus. Le système, le shell, un orchestrateur ou une plateforme de déploiement la transmettent à l’application. Le code lit ensuite cette valeur pour savoir comment se comporter : quel port écouter, quelle base joindre, quel mode activer ou quel service externe appeler.
Cette valeur n’appartient pas à toute la machine de façon abstraite : elle appartient d’abord au processus qui la reçoit et, selon les cas, à ses processus enfants. C’est une différence importante. Deux services déployés sur le même serveur peuvent donc utiliser des variables différentes, à condition que le lancement, le conteneur ou le gestionnaire de service les isole correctement. C’est ce qui permet de faire cohabiter plusieurs applications sans leur donner la même configuration.
Le principe est simple : ne pas écrire dans le code ce qui dépend du contexte d’exécution. Un fichier source ne devrait pas contenir l’URL de production, le mot de passe d’une base ou un jeton d’API. Il devrait seulement demander une variable bien nommée, puis refuser de démarrer si elle manque, avec un message compréhensible par la personne qui déploie.
Ce découplage aide aussi les PME qui n’ont pas une grosse équipe DevOps. Le développeur, l’administrateur système et l’hébergeur peuvent parler des mêmes noms de variables sans modifier le code à chaque changement d’infrastructure.
Le nom décrit-il clairement son usage ?
Impact décision : Réduit les confusions entre équipes.
Qui doit lire cette valeur ?
Impact décision : Limite les fuites et les effets de bord.
Que se passe-t-il si elle manque ?
Impact décision : Évite les pannes silencieuses.
La bonne variable est celle qui reste lisible sous pression, même quand l’équipe corrige un incident hors horaires.
Une variable d’environnement convient bien aux valeurs qui changent selon l’environnement : APP_ENV, DATABASE_URL, API_BASE_URL, LOG_LEVEL, REDIS_URL ou un identifiant de bucket. Elle convient aussi aux secrets injectés par une plateforme, à condition qu’ils soient gérés avec les bons droits.
En revanche, elle ne remplace pas une vraie politique de secrets. Si tout le monde peut lire les variables du serveur ou si elles s’affichent dans les logs, le risque reste entier. Le danger ne vient pas du mécanisme, mais de la façon dont il est exposé, copié et transmis.
Une clé API dans une variable d’environnement reste une clé API exploitable. Si elle fuit, l’attaquant ne se demande pas si elle venait d’un fichier, d’un coffre ou d’un export shell : il teste les droits associés. La protection réelle vient de la rotation, des permissions limitées, du masquage dans les journaux et d’une séparation nette entre comptes de test et comptes de production, avec des droits adaptés à chaque usage réel.
Gardez une règle courte : un secret ne doit jamais apparaître dans Git. Ni dans le code, ni dans un fichier .env réel, ni dans une capture d’écran de debug. Un exemple de configuration peut être versionné, mais uniquement avec des valeurs factices.
Le même nom peut exister partout ; la valeur, elle, doit rester propre à chaque environnement réel.
Pour approfondir ce point, consultez Buzz marketing : définition, leviers et risques, qui traite plus précisément de buzz marketing : définition, leviers et risques d’un phénomène viral.
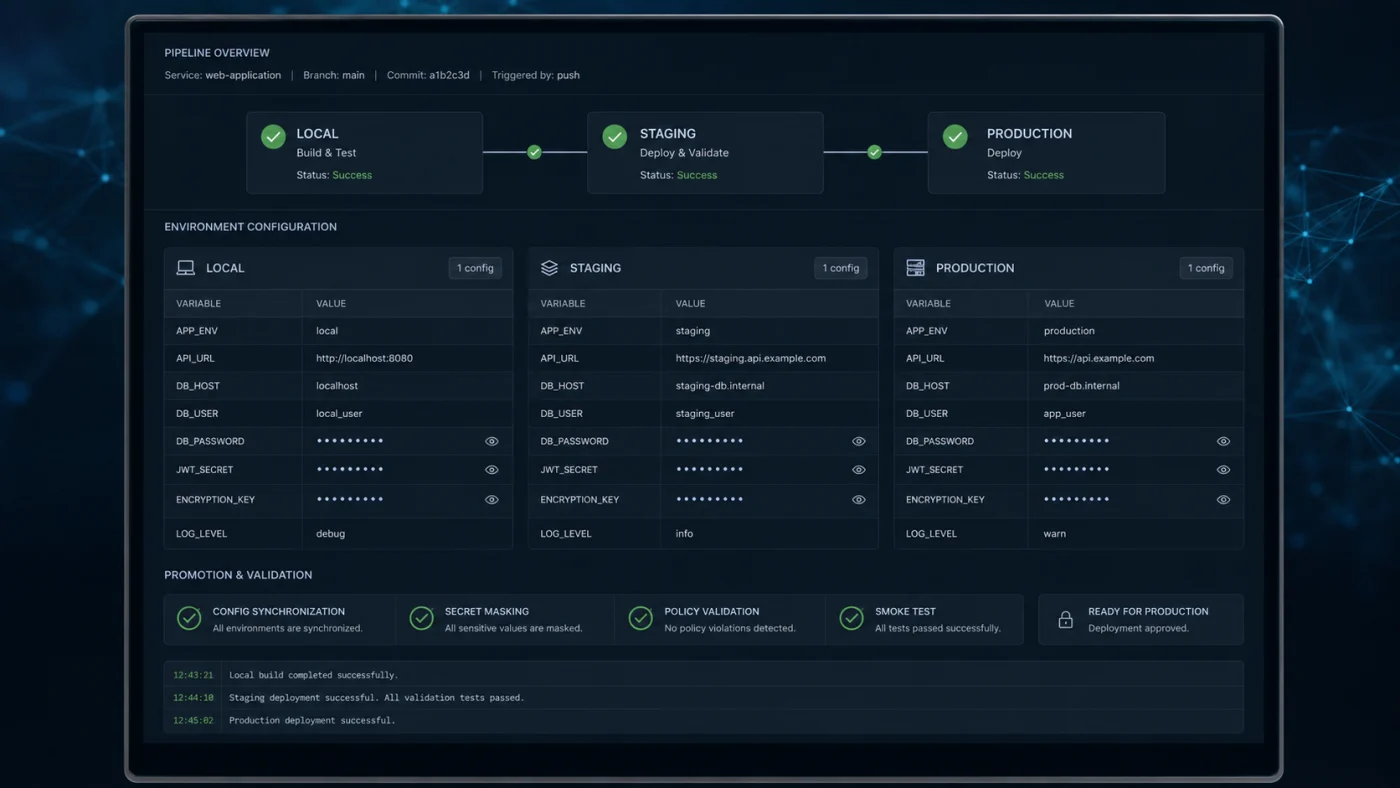
Le même nom de variable peut exister dans plusieurs environnements, mais avec une valeur différente. En local, DATABASE_URL pointe vers une base de test. En staging, elle pointe vers une base de préproduction. En production, elle utilise une valeur injectée par l’infrastructure, avec des droits limités et une rotation contrôlée. Le code ne change pas, mais son environnement explique précisément quel système il doit contacter, et avec quel niveau de confiance.
Cette séparation évite un grand classique : tester une correction sur la mauvaise base ou envoyer des emails réels depuis un environnement de recette. Elle permet aussi de garder des paramètres plus prudents en production : logs moins bavards, mode debug désactivé, services externes réellement surveillés.
Le piège consiste à gérer ces valeurs à la main, dans des documents partagés ou des conversations. Plus l’équipe grandit, plus cette méthode devient fragile. Mieux vaut définir une liste courte de variables attendues, les documenter et les stocker au bon endroit pour chaque environnement.
Même une petite application gagne à séparer local, staging et production dès le départ, y compris sur un seul serveur.
Un fichier local reste pratique, mais il ne doit jamais devenir la mémoire secrète du projet. Son rôle est d’aider le développement, pas de concentrer des mots de passe copiés d’une machine à l’autre. Dès qu’il contient une vraie valeur sensible, il doit être traité comme un fichier privé, ignoré par Git et remplacé par un exemple neutre dans le dépôt, lisible aussi par une nouvelle recrue. Ce point doit rester visible dans la documentation d’exploitation.
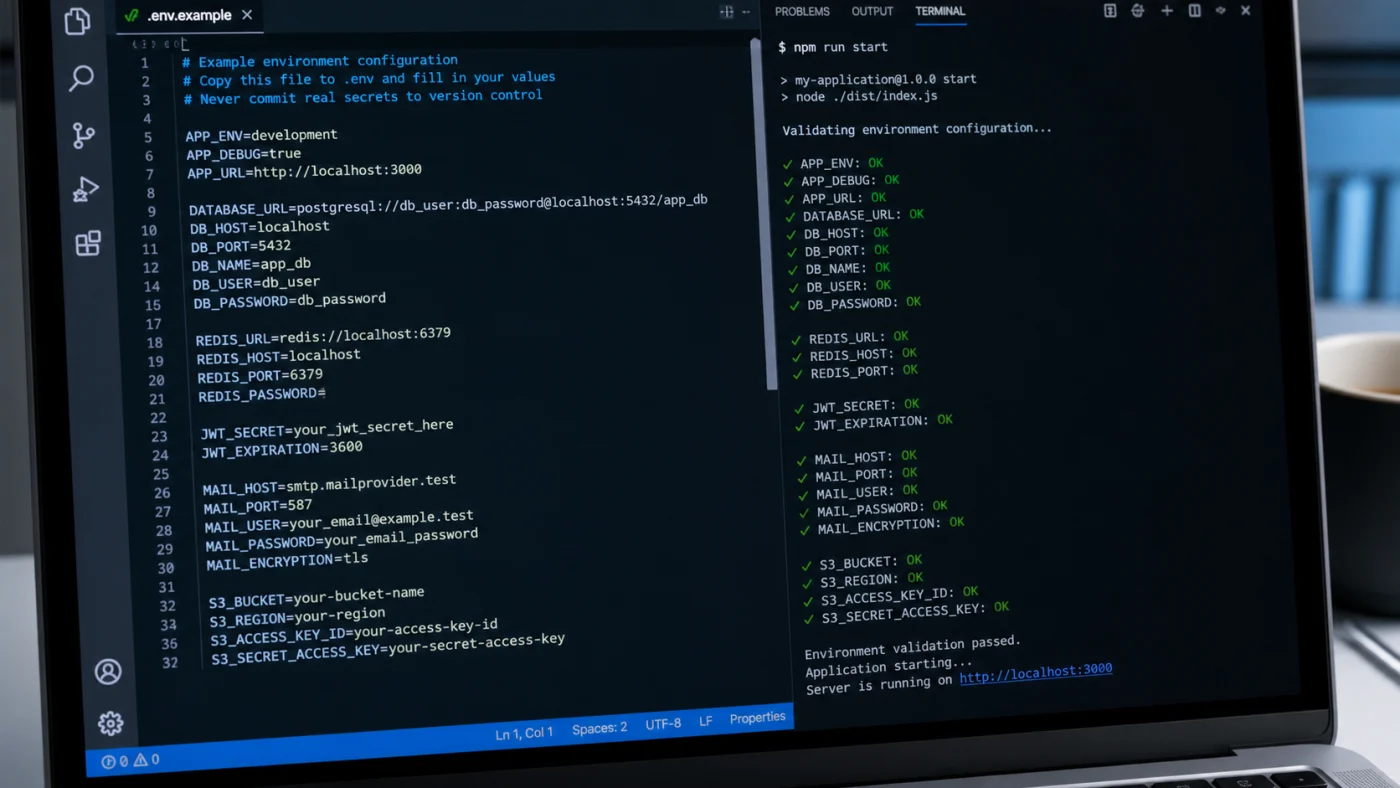
Le fichier .env rend le développement plus confortable : chaque personne peut lancer l’application avec ses propres valeurs. Il est utile pour éviter de taper quinze exports dans un terminal. Mais il doit rester local. S’il contient des secrets, il doit être ignoré par Git et remplacé dans le dépôt par un .env.example sans valeur réelle.
Un bon .env.example indique les noms obligatoires, les formats attendus et parfois une valeur neutre. Il ne contient ni token, ni mot de passe, ni clé privée. C’est une documentation exécutable : l’équipe sait quoi fournir sans récupérer les secrets de quelqu’un d’autre.
La validation au démarrage complète ce dispositif. Si DATABASE_URL manque, l’application doit échouer immédiatement avec un message clair. Si APP_ENV contient une valeur inconnue, elle doit le signaler avant de traiter une requête. Cette discipline transforme une panne obscure en correction rapide.
Sur un projet JavaScript, cette validation peut rester très simple : une petite fonction centralise les variables attendues, vérifie leur présence, convertit les booléens ou les nombres, puis exporte un objet de configuration typé. Le reste de l’application ne lit plus directement process.env partout. Elle consomme une configuration déjà contrôlée, ce qui réduit les erreurs de nommage, les valeurs inattendues et les comportements différents entre deux fichiers qui croyaient lire la même information.
La fuite commence souvent par un geste banal, pas par une attaque sophistiquée. Un fichier ajouté trop vite, une capture de debug, une variable imprimée dans les logs ou un message envoyé dans l’urgence suffit à exposer une clé. C’est pourquoi la prévention doit viser les habitudes quotidiennes, pas seulement les scénarios de cybersécurité spectaculaires ou les audits annuels trop espacés. La règle doit donc être simple à appliquer chaque jour.
La première erreur est le commit accidentel. Il arrive souvent après un test rapide, quand un fichier .env n’a pas été ajouté au .gitignore. Une fois poussé sur un dépôt distant, un secret doit être considéré comme compromis. Le supprimer de la branche ne suffit pas toujours : il faut le révoquer et le remplacer.
La deuxième erreur est le log trop bavard. Une application qui imprime toute sa configuration au démarrage peut révéler des clés dans les traces d’incident, les outils APM ou les captures envoyées au support. Les valeurs sensibles doivent être masquées, même quand le message semble destiné à l’équipe interne.
La troisième erreur est le partage informel. Copier une chaîne de connexion dans un ticket, un chat ou un document collaboratif crée une surface d’exposition inutile. Pour les secrets de production, utilisez plutôt un gestionnaire de secrets, des droits limités et un historique d’accès.
Le cas le plus trompeur reste l’incident urgent. Quelqu’un veut corriger vite, colle une variable dans un message privé, puis promet de la supprimer après coup. En pratique, la valeur a déjà transité par des notifications, des sauvegardes et parfois des intégrations tierces. Pour une équipe, le canal d’urgence doit être prévu avant l’urgence : accès temporaire, coffre partagé, journal d’accès, révocation rapide et consigne claire sur ce qui ne doit jamais circuler en clair.
Un nom de variable doit être lisible sans ouvrir toute l’application. DATABASE_URL est plus clair que DB, PUBLIC_API_BASE_URL est plus explicite que URL, et FEATURE_BILLING_ENABLED dit mieux ce qu’il contrôle qu’un simple FLAG. Cette précision évite les mauvais raccordements entre équipes.
Pour compléter cette lecture, Créer une CSR OpenSSL sans exposer votre apporte des repères utiles sur créer une csr openssl sans exposer votre clé privée.
La cohérence compte autant que le nom lui-même. Évitez de mélanger APP_ENV, NODE_ENV, ENV_MODE et MODE si ces variables parlent du même sujet. Choisissez une convention, documentez-la, puis gardez-la dans tous les services concernés.
Pour une PME, la documentation peut rester simple : un tableau dans le README ou dans une fiche d’exploitation. Il doit préciser le nom, l’usage, le caractère obligatoire, l’exemple non sensible et l’environnement concerné. C’est suffisant pour réduire les erreurs de déploiement.
Un bon nom doit aider la personne d’astreinte, pas seulement le développeur qui l’a créé, au moment exact où l’incident arrive.
Évitez aussi les variables qui mélangent plusieurs décisions. Une valeur comme CONFIG_MODE peut cacher à la fois le niveau de logs, l’URL d’API et l’activation d’une fonctionnalité. C’est pratique au début, puis dangereux quand il faut changer un seul comportement. Préférez plusieurs variables explicites, avec une valeur par responsabilité, quitte à documenter leur combinaison dans une section courte et à refuser les raccourcis qui masquent plusieurs effets secondaires.
| Variable | Rôle | Point de vigilance |
|---|---|---|
| APP_ENV | Identifier local, staging ou production | Ne pas activer le debug en production |
| DATABASE_URL | Connecter l’application à sa base | Secret à injecter et masquer |
| LOG_LEVEL | Régler le volume de logs | Éviter les logs sensibles |
| FEATURE_X_ENABLED | Activer une fonctionnalité | Prévoir un retour arrière |
Un déploiement fiable vérifie la configuration avant de déclarer le code prêt. La compilation et les tests ne prouvent pas que la production possède les bonnes valeurs. Une vérification de démarrage, une smoke test et un contrôle des secrets masqués donnent une preuve plus utile : l’application sait lire son environnement réel sans révéler ce qu’elle doit protéger, même quand les traces sont consultées hors équipe technique. Ce contrôle vaut autant pour une PME que pour une grande plateforme.
Avant un déploiement, vérifiez que l’environnement cible possède toutes les variables obligatoires. Une pipeline sérieuse ne se contente pas de compiler le code. Elle contrôle aussi la configuration : valeurs présentes, secrets masqués, variables cohérentes avec l’environnement et tests de démarrage réussis.
Cette étape évite les incidents les plus évitables. Une application peut passer tous les tests unitaires et échouer au lancement parce qu’un nom de variable a changé. Un service peut démarrer avec une ancienne URL et envoyer des données au mauvais endpoint. Un niveau de log trop élevé peut exposer plus d’informations que prévu, alors que le code applicatif n’a techniquement pas régressé et semble correct en revue.
La bonne pratique consiste à traiter la configuration comme un livrable. Elle a une liste d’attendus, une revue, un changement tracé et un test après déploiement. Ce n’est pas de la paperasse : c’est ce qui empêche un paramètre oublié de devenir une panne de production.
Pour limiter le risque, gardez un plan de retour arrière aussi concret que le changement lui-même. Si la nouvelle variable casse le démarrage, qui peut remettre l’ancienne valeur ? Où se trouve la valeur précédente ? Quelle smoke test confirme que l’application répond vraiment ? Ces réponses paraissent modestes, mais elles accélèrent fortement une correction sous pression et évitent d’improviser avec des secrets en clair dans un canal non prévu.
La remise en ordre doit commencer par les valeurs qui peuvent faire le plus de dégâts. Une variable de couleur d’interface attendra ; une chaîne de connexion, une clé de signature ou un jeton de paiement non maîtrisé doit passer avant. Cette hiérarchie évite de transformer un chantier de propreté en inventaire interminable sans réduction concrète du risque pour la disponibilité, la confidentialité et les coûts externes. Le premier tri doit rester orienté impact.
Si votre projet a grandi sans méthode, ne cherchez pas à tout corriger en une seule fois. Commencez par les variables sensibles : base de données, tokens, clés de signature, services de paiement, stockage et emails. Ensuite, documentez les variables obligatoires, puis ajoutez une validation au démarrage.
La deuxième priorité est le nettoyage des usages ambigus. Supprimez les variables mortes, renommez celles qui se contredisent et vérifiez que local, staging et production utilisent les mêmes noms. Une configuration courte et claire se surveille mieux qu’un inventaire historique jamais purgé.
Enfin, testez le scénario de panne. Que se passe-t-il si une variable manque ? Le service refuse-t-il de démarrer ? Le message d’erreur indique-t-il la variable concernée sans afficher le secret ? Ces détails font la différence entre une alerte traitable et une recherche longue en pleine interruption.
Si vous ne devez faire qu’une action, créez un .env.example propre, ajoutez les vrais fichiers .env au .gitignore, puis mettez une validation de configuration au démarrage. Cette base ne règle pas toute la sécurité, mais elle retire les erreurs les plus fréquentes : secret commité, variable oubliée, environnement confondu. C’est souvent le meilleur ratio effort/réduction du risque sur un projet existant.
Ensuite seulement, formalisez la gestion des secrets de production. Un coffre, des droits limités, une rotation et des logs masqués apportent une protection réelle. Les variables d’environnement restent un outil simple ; leur valeur dépend de la discipline que vous mettez autour.
Pour approfondir ce point, consultez Protégez votre identité : intégrez un filigrane, qui traite plus précisément de protégez votre identité : intégrez un filigrane à vos documents avant de les diffuser !.
À lire aussi

Ubuntu Server est un bon choix pour héberger des services Linux stables, à condition de préparer la version LTS, l'accès SSH, les mises à jour, le pare-feu et les sauvegardes.
Recherchez-vous un équipement capable de vous aider dans la gestion de votre organisation? Les imprimantes de codes-barres occupent une place importante dans de nombreux secteurs. Elles permettent d'identifier rapidement les produits, colis.
Les vérifications à faire avant d'utiliser un outil de reconnaissance faciale, de recherche d'image visage ou d'analyse biométrique.

Un support utilisateur PME efficace ne repose pas seulement sur un outil de ticketing. Il clarifie les demandes, les priorités, les délais, l'escalade et la mémoire de résolution.

Sous Linux, supprimer un dossier dépend surtout de son contenu. Voici quelle commande choisir et les précautions à prendre avant une suppression récursive.

Les commandes Linux utiles ne se résument pas à une liste: il faut comprendre le contexte, les options et le risque avant d'exécuter.
