
La gouvernance des coûts
Budgets, alertes, tags et extinction des ressources évitent que le paiement à l’usage devienne une facture opaque.


Logiciels Services
AWS, pour Amazon Web Services, désigne la plateforme cloud d’Amazon. Elle permet de louer à la demande des ressources informatiques : serveurs, stockage, bases de données, réseau, sécurité, outils de déploiement, analyse de données ou services d’intelligence artificielle. Pour une PME ou une DSI, la question n’est donc pas seulement “AWS, c’est quoi ?”, mais ce que l’on veut déléguer, contrôler et payer différemment.
Le cloud AWS peut accélérer un projet, éviter l’achat de serveurs surdimensionnés et rendre une infrastructure plus souple. Il peut aussi créer une facture difficile à lire si les droits, les sauvegardes, les environnements de test et la supervision sont traités trop tard. La bonne lecture est pragmatique : AWS est une boîte à outils d’infrastructure, pas une solution magique qui remplace l’architecture, l’exploitation et la gouvernance.
AWS est un fournisseur de cloud computing. Au lieu d’acheter, installer et maintenir vous-même tous les serveurs nécessaires à une application, vous utilisez des ressources disponibles dans les centres de données d’Amazon. Vous créez une machine virtuelle, un espace de stockage ou une base de données depuis une console, une API ou un outil d’automatisation, puis vous payez selon l’usage réel et le modèle choisi, avec des engagements possibles lorsque la charge devient prévisible.
La différence avec un hébergement classique tient à l’étendue du catalogue. AWS ne vend pas uniquement “un serveur en ligne”. La plateforme rassemble des services pour construire une application complète : puissance de calcul, stockage objet, bases de données managées, réseau privé, répartition de charge, sauvegarde, chiffrement, logs, alertes, déploiement, conteneurs, serverless et outils de données. Cette profondeur explique son intérêt, mais aussi le besoin de choisir peu de briques au départ.
Pour vulgariser, AWS ressemble à un grand atelier technique. Vous pouvez y louer un établi, des machines spécialisées, des armoires sécurisées et des outils de mesure. Mais c’est toujours à vous de choisir le bon plan, les bonnes permissions, les bons seuils de coût et le bon niveau de maintenance.
Cette nuance est importante pour éviter les décisions trop rapides. Une direction peut entendre “cloud” et imaginer une externalisation complète du problème informatique. En réalité, AWS déplace les responsabilités : Amazon fournit une plateforme puissante, mais votre équipe garde la conception, la qualité des configurations, les choix de disponibilité, les règles d’accès, les données à sauvegarder et le pilotage financier. Le cloud simplifie l’accès aux ressources, pas la responsabilité de les exploiter correctement.
Le premier intérêt est la rapidité. Un serveur physique demande achat, livraison, installation, mise en réseau et maintenance. Sur AWS, un environnement peut être créé beaucoup plus vite, surtout si l’équipe utilise l’infrastructure as code. Cette vitesse aide à tester une idée, lancer un extranet, absorber une montée de trafic ou créer une plateforme de données sans attendre un cycle matériel complet, tout en conservant la possibilité de reconstruire le même environnement proprement.
Le second intérêt est l’élasticité. Une application peut demander plus de ressources pendant une campagne commerciale, puis revenir à une taille plus basse. Cette logique évite une partie du surdimensionnement permanent, à condition de paramétrer correctement l’autoscaling et les limites budgétaires. L’élasticité sans garde-fou peut devenir un avantage technique et un problème financier dans le même mois.
Le troisième intérêt est l’accès à des services managés. Une base de données, une file de messages ou un stockage d’objets peuvent être exploités sans gérer chaque couche système. Cela ne supprime pas la responsabilité de conception, mais réduit la charge d’exploitation sur certains sujets. Pour une PME, c’est souvent le point décisif : concentrer l’équipe sur l’application métier plutôt que sur tous les détails matériels.
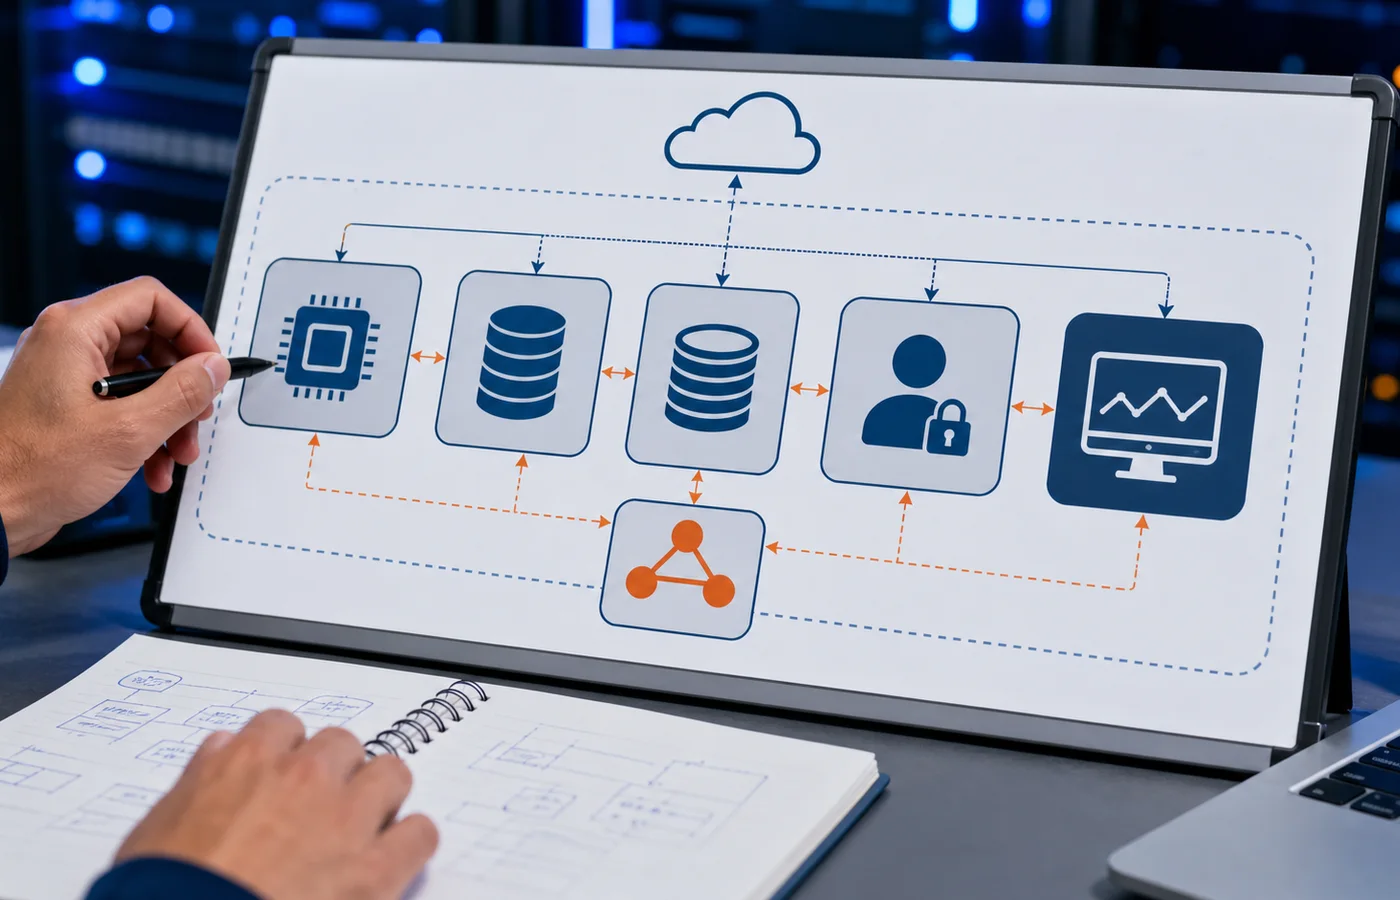
Le catalogue AWS dépasse largement les deux cents services, mais un décideur n’a pas besoin de tous les mémoriser. Il doit surtout comprendre les familles de services qui structurent la plupart des projets. Cette lecture évite deux erreurs fréquentes : réduire AWS à un hébergeur de serveurs ou, à l’inverse, empiler des services avancés avant d’avoir sécurisé les fondations.
Pour approfondir ce point, consultez Le Wi-Fi expliqué simplement sans jargon, qui traite plus précisément de le wi-fi expliqué simplement sans jargon.
| Famille | Rôle simple | Exemple d’usage |
|---|---|---|
| Calcul | Faire tourner applications, conteneurs ou fonctions. | Serveur applicatif, API, traitement planifié. |
| Stockage | Conserver fichiers, sauvegardes, archives ou objets. | Images, documents, exports, logs. |
| Bases de données | Stocker les données métier avec maintenance partiellement gérée. | CRM, catalogue, comptes clients. |
| Identité et sécurité | Contrôler qui peut faire quoi. | Droits administrateurs, rôles applicatifs, audit. |
| Réseau | Isoler, connecter et exposer les ressources. | VPC, sous-réseaux, load balancer, VPN. |
| Supervision | Mesurer santé, logs, alertes et coûts. | Détection d’incident, seuils, tableaux de bord. |
Les noms exacts comptent ensuite : EC2 pour des machines virtuelles, S3 pour du stockage objet, RDS pour certaines bases de données managées, IAM pour les permissions, VPC pour le réseau isolé, CloudWatch pour une partie de l’observation. Mais la priorité reste de relier chaque service à un besoin d’architecture, pas de cocher des acronymes pour donner une impression de modernité.
AWS s’appuie sur une infrastructure mondiale composée de régions et de zones de disponibilité. Pour un lecteur non technique, cela signifie que les ressources ne flottent pas dans un nuage abstrait : elles sont hébergées dans des emplacements physiques, reliés par le réseau, avec des choix de localisation, de latence, de résilience et de conformité. La région choisie influence donc la performance, certaines obligations de données et parfois le coût.
Une architecture robuste ne se contente pas de créer une ressource dans une seule zone. Elle peut répartir une application sur plusieurs zones de disponibilité, prévoir des sauvegardes dans un autre périmètre ou mettre en place un plan de reprise. Ces choix ont un prix, mais ils évitent de confondre “être dans le cloud” avec “être automatiquement résilient”. La disponibilité se conçoit, se teste et se surveille comme dans une infrastructure classique.
Le sujet devient vite concret lors d’un incident.
Si une base de données, un serveur applicatif ou une règle réseau tombe, qui reçoit l’alerte ? Qui sait redémarrer proprement ? Quelle donnée peut être perdue ? Combien de temps l’entreprise accepte-t-elle d’être indisponible ? Ces questions relèvent de la continuité d’activité, pas seulement du choix d’un fournisseur cloud. AWS donne les options ; l’entreprise doit choisir le niveau de protection qui correspond à son risque métier.
AWS transforme une partie des dépenses d’infrastructure en dépenses d’usage. C’est utile lorsqu’un projet varie, démarre petit ou doit accélérer. Mais le paiement à l’usage exige une discipline nouvelle : tags de coût, budgets, alertes, extinction des environnements inutilisés, choix des tailles d’instances, durées de rétention, stratégie de sauvegarde et revue mensuelle. Le cloud ne pardonne pas l’oubli : une ressource laissée active continue de coûter.
Le vrai sujet n’est donc pas “AWS est-il moins cher ?”. Il faut comparer le coût total : infrastructure, licences, exploitation, sauvegardes, sécurité, support, trafic sortant, temps équipe et risque d’indisponibilité. Un projet très variable peut bénéficier fortement du cloud. Une charge stable, prévisible et déjà amortie peut demander une analyse plus fine, surtout si elle consomme beaucoup de réseau ou de stockage longue durée.
La tarification AWS doit aussi être lue avec ses effets secondaires. Le stockage peut sembler économique, puis devenir lourd si les versions, snapshots ou archives ne sont jamais purgés. Une application peut coûter peu en calcul, mais générer une facture réseau importante. Un service managé peut économiser des jours d’administration, tout en demandant une surveillance budgétaire plus rigoureuse qu’un serveur acheté une fois.
Le coût doit donc être piloté comme un indicateur de production, pas comme une ligne comptable relue trop tard.
AWS sécurise son infrastructure physique, ses centres de données et une partie des couches gérées par ses services. L’entreprise cliente conserve toutefois une responsabilité majeure : configuration, comptes, permissions, chiffrement côté usage, règles réseau, sauvegardes, rotation des secrets, journalisation et traitement des alertes. C’est le principe de responsabilité partagée, souvent mal compris lors des premiers projets cloud.
La plupart des incidents ne viennent pas d’un manque de puissance de la plateforme, mais d’une mauvaise configuration. Un stockage trop ouvert, une clé d’accès oubliée, un rôle administrateur trop large ou une absence de logs peuvent exposer une organisation. AWS fournit les briques, mais la politique de sécurité doit rester écrite, testée et contrôlée. L’architecture doit donc intégrer la sécurité dès le premier schéma, pas après le déploiement.
Pour une PME, le socle minimal tient en quelques règles : comptes séparés, authentification forte, droits minimaux, sauvegardes testées, chiffrement adapté, journalisation centralisée et revue régulière des accès. Sans cette base, le cloud gagne en vitesse mais perd en maîtrise. Cette discipline n’est pas bureaucratique : elle protège surtout les petites équipes, qui n’ont pas toujours le temps de reconstruire une architecture dans l’urgence.
AWS n’est pas neutre dans une stratégie informatique. Plus vous utilisez des services spécifiques, plus vous gagnez en vitesse, mais plus vous devez documenter votre dépendance. Ce n’est pas forcément un problème : beaucoup d’entreprises acceptent un fournisseur cloud majeur parce que le gain opérationnel est réel. Le risque apparaît lorsque la dépendance fournisseur n’a jamais été discutée, mesurée ou compensée par une architecture réversible sur les points critiques.
La compétence interne est l’autre limite. Une petite équipe peut très bien gérer un projet AWS sobre, mais elle doit savoir lire une facture, comprendre IAM, maintenir les sauvegardes, contrôler le réseau et répondre aux alertes. Sans cette base, le cloud donne une impression de simplicité pendant la création, puis révèle sa complexité pendant l’exploitation. Le sujet n’est pas de tout maîtriser dès le premier jour, mais de savoir ce que l’on ne sait pas encore et de prévoir l’accompagnement correspondant.
Un projet AWS doit donc prévoir de la documentation vivante.
Schémas d’architecture, propriétaires de ressources, conventions de nommage, tags, procédures d’incident, sauvegardes et règles de suppression doivent être lisibles par quelqu’un d’autre que la personne qui a créé le compte. Dans une logique de modernisation Linux/Unix et d’infrastructure d’entreprise, cette documentation vaut autant que les services déployés. Elle transforme une expérimentation cloud en patrimoine technique exploitable.
AWS apporte de la souplesse, mais la décision doit rester cadrée par la gouvernance et le mode de migration.
Budgets, alertes, tags et extinction des ressources évitent que le paiement à l’usage devienne une facture opaque.

Un pilote isolé permet de tester réseau, sauvegardes, sécurité et supervision avant de déplacer une application critique.
AWS est pertinent lorsqu’un projet doit évoluer vite, supporter des variations de charge, utiliser des services managés ou s’intégrer dans une stratégie de modernisation. Il est aussi intéressant pour des environnements de test, des traitements ponctuels, une plateforme de données ou une application dont l’activité change selon les périodes. Dans ces cas, la flexibilité opérationnelle peut justifier l’apprentissage et la gouvernance nécessaires.
Il faut temporiser lorsque l’organisation n’a pas encore de responsable clair, pas de méthode de supervision, pas de budget suivi ou pas de compétences minimales en réseau et sécurité. Migrer vers AWS sans exploitation préparée revient à déplacer le problème. Le cloud rend les ressources plus accessibles ; il ne rend pas automatiquement l’architecture plus propre.
| Situation | AWS peut aider si… | Point de vigilance |
|---|---|---|
| Application web | Le trafic varie ou le déploiement doit accélérer. | Supervision, sauvegardes, droits et coûts sortants. |
| Migration de serveurs | Le périmètre est priorisé par lots. | Ne pas copier la dette technique telle quelle. |
| Données et analytics | Les volumes évoluent et les traitements sont ponctuels. | Gouvernance, qualité de données, confidentialité. |
| Environnement de test | Les ressources peuvent être créées puis arrêtées. | Extinction automatique et quotas stricts. |
La meilleure entrée n’est pas de créer un compte puis d’essayer tous les services. Commencez par une application ou un besoin précis : héberger un petit service interne, stocker des sauvegardes non critiques, créer un environnement de recette ou moderniser une API isolée. Ce périmètre doit être assez utile pour apprendre, mais pas assez critique pour mettre l’activité en risque au premier incident.
Définissez ensuite l’architecture cible minimale : réseau, comptes, droits, sauvegardes, logs, coûts, procédure de retour arrière. Le pilote doit produire une preuve exploitable, pas seulement une démonstration séduisante. À la fin, vous devez savoir ce qui fonctionne, ce qui coûte, ce qui doit être automatisé et ce qui reste trop fragile pour une mise en production.
Ce pilote doit aussi tester l’organisation. Qui valide une demande de nouvelle ressource ? Qui peut augmenter un quota ? Qui arbitre entre performance et coût ? Qui maintient l’automatisation ? Si ces réponses ne sont pas claires, le projet AWS risque de réussir techniquement tout en créant une exploitation confuse. Une migration cloud sérieuse mesure donc autant les processus que les services.
Ces points évitent de démarrer par la console et de découvrir les vrais sujets trop tard.
La bonne façon de comprendre AWS est de le lire comme une plateforme d’industrialisation, pas comme un simple hébergement. Elle devient utile lorsque l’entreprise sait ce qu’elle veut accélérer, ce qu’elle accepte de déléguer et ce qu’elle doit garder sous contrôle. Pour une DSI qui modernise son infrastructure, la priorité n’est pas de “passer sur AWS”, mais de construire un socle cloud exploitable : sécurité, coûts, réseau, sauvegardes, supervision et méthode de migration.
La prochaine action est simple : choisissez un cas pilote, chiffrez le coût attendu, écrivez le plan de retour arrière et testez l’exploitation avant d’étendre le périmètre.
Pour compléter cette lecture, l’interconnexion des réseaux sans jargon inutile apporte des repères utiles sur comprendre l’interconnexion des réseaux sans jargon inutile.
Ces pages AWS servent de référence pour les concepts, la tarification, l’infrastructure mondiale et le cadre d’architecture.
Présentation officielle d’AWS, de son périmètre cloud et de ses grandes familles de services.
ConsulterDéfinition officielle du cloud computing et de ses bénéfices opérationnels.
ConsulterPage officielle sur les principes de tarification AWS et le paiement à l’usage.
ConsulterCadre officiel pour concevoir des architectures cloud robustes, sûres, performantes et maîtrisées.
Consulter
À lire aussi

PDF-XChange Editor peut remplacer un simple lecteur PDF quand il faut annoter, modifier, OCRiser ou traiter des formulaires, à condition de vérifier les fonctions sous licence.

Un PDF joiner fusionne plusieurs fichiers, mais le bon choix dépend surtout de la confidentialité, de l'ordre des pages et du contrôle final.
Guide pratique pour comprendre Safari on Windows, eviter les anciens installateurs et choisir une methode de test Safari ou WebKit fiable.

Steam fonctionne sur Linux, mais l'expérience dépend surtout du jeu, de Proton, des pilotes graphiques et de la distribution utilisée.

PDFsam peut être utile quand il faut organiser des PDF en local, mais il ne remplace pas tous les éditeurs PDF.

Un PDF se modifie en ligne pour des corrections simples, mais pas pour tous les documents ni tous les usages sensibles.
