Chatbot
Répond
Risque principal: réponse fausse, fuite de données saisies, hallucination ou conseil mal compris.


Cybersécurité
Un agent IA n'est pas seulement un chatbot plus autonome. Dès qu'il peut appeler des outils, lire des fichiers, interroger une API, déclencher une action ou prendre une décision en chaîne, il devient un acteur technique dans le système d'information. C'est là que le sujet cybersécurité change vraiment: le risque ne vient plus seulement de la réponse produite, mais de ce que l'agent est autorisé à faire.
Pour une PME, l'enjeu n'est donc pas de bannir les agents IA par réflexe. L'enjeu est plus concret: savoir quels agents existent, quelles données ils manipulent, quels droits ils possèdent, quelles actions ils peuvent lancer et qui vérifie leurs décisions. Un agent utile peut faire gagner du temps. Un agent mal cadré peut devenir un raccourci d'attaque.
Un modèle de langage classique répond à une consigne. Un agent va plus loin: il découpe une tâche, choisit une étape, appelle un outil, relit le résultat, puis continue. Cette boucle d'action rend le système plus puissant, mais elle ajoute des points d'entrée. Une consigne malveillante, un fichier piégé, un connecteur trop large ou une mauvaise séparation des droits peuvent influencer la chaîne complète.
Le danger n'est pas uniquement théorique. Dans une architecture agentique, l'agent peut recevoir des informations venues de sources différentes: ticket support, email, page web, base documentaire, CRM, dépôt de code, outil de facturation, drive partagé. Si une de ces sources contient une instruction cachée, l'agent peut la lire comme une consigne à suivre. C'est le principe de l'injection indirecte.
Le piège est là. L'agent lit une donnée, mais il peut croire recevoir un ordre. La séparation des rôles doit être explicite.
La nouveauté, c'est que l'agent peut ensuite agir. Il peut résumer un contrat, mais aussi l'envoyer. Il peut analyser un ticket, mais aussi ouvrir un accès. Il peut aider un développeur, mais aussi proposer une commande risquée. Plus l'agent est connecté, plus il faut le considérer comme un composant applicatif critique.
Le vocabulaire compte. Parler d'assistant masque parfois le fait qu'il s'agit déjà d'un acteur applicatif.
La différence utile pour décider les contrôles tient surtout au niveau d'autonomie et aux droits techniques.
Répond
Risque principal: réponse fausse, fuite de données saisies, hallucination ou conseil mal compris.
Assiste
Risque principal: accès documentaire trop large, suggestion dangereuse, dépendance excessive de l'utilisateur.
Agit
Risque principal: exécution d'actions via outils, API, workflow, identité technique ou connecteur métier.
Les attaques contre les agents IA ne se résument pas à demander au modèle de "faire le mal". Les scénarios les plus crédibles passent par les interfaces ordinaires. Un document importé peut contenir une consigne destinée à l'agent. Une page web consultée par l'agent peut essayer de détourner sa tâche. Un plugin peut demander plus de droits que nécessaire. Un outil interne peut accepter une action sans validation humaine.
Le premier levier est donc la confusion d'instructions. L'agent doit distinguer la demande de l'utilisateur, les règles système, les données non fiables et le résultat d'un outil. Quand cette séparation est floue, une information externe peut être traitée comme une instruction. Le deuxième levier est l'abus de permissions: si l'agent dispose d'un accès large, l'erreur ou la manipulation produit plus de dégâts.
Le troisième levier est plus discret: la chaîne d'outils. Un agent peut appeler un service pour lire un fichier, puis un autre pour envoyer un message, puis un troisième pour mettre à jour une fiche client. Chaque outil paraît légitime isolément. Ensemble, ils peuvent créer un chemin d'exfiltration ou une action métier non prévue.
Une permission faible dans le mauvais outil peut suffire. C'est rarement spectaculaire, mais souvent exploitable dans une chaîne d'actions.
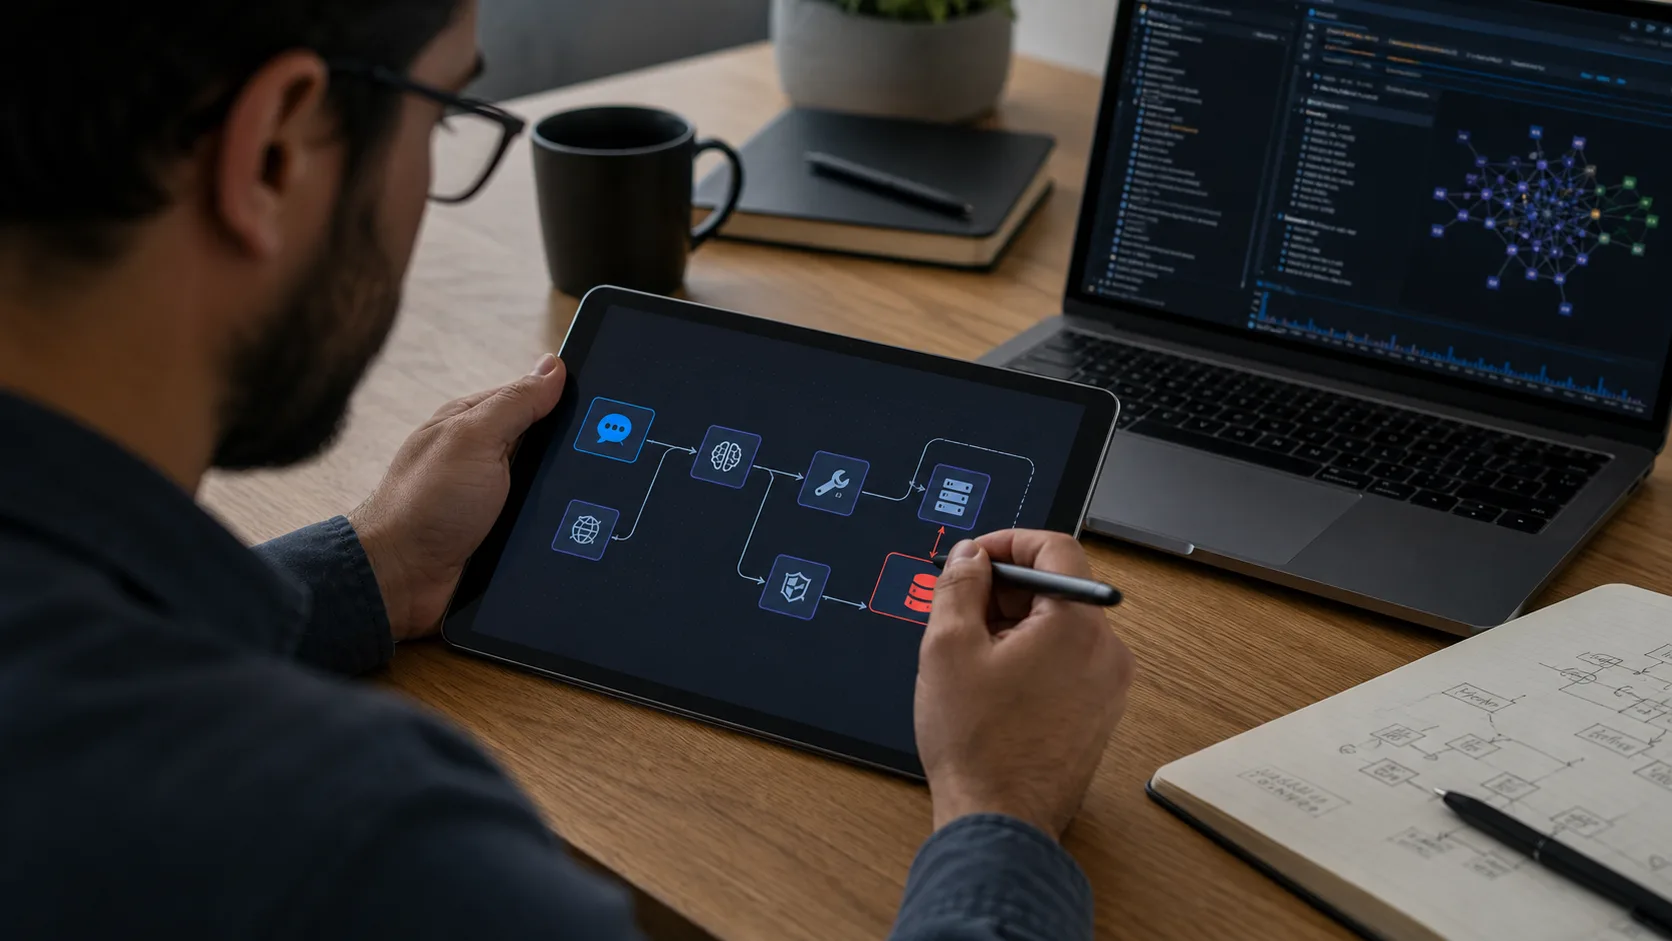
Une attaque réussie commence souvent par une situation banale. Un collaborateur demande à l'agent de résumer un document reçu. Dans ce document, une instruction cachée demande à l'agent d'ignorer certaines règles ou de transmettre une information ailleurs. Si l'agent traite le document comme une source de vérité, il peut modifier son comportement sans que l'utilisateur comprenne pourquoi.
Pour approfondir ce point, consultez Incident Salesloft Drift : ce que les, qui traite plus précisément de incident salesloft drift : ce que les dsi doivent vérifier.
Le problème devient critique lorsque l'agent a accès à des outils. Lire un document est une chose. Envoyer un email, modifier un ticket, créer un compte, générer une clé d'API, lancer un script ou valider une commande en est une autre. Dans ces cas, la frontière entre assistance et exécution doit être dessinée avant la mise en production.
Le bon seuil est simple: tout ce qui change l'état d'un système mérite une validation explicite. L'autonomie s'arrête là.
Il faut aussi regarder les réponses longues. Un agent qui produit du code, des commandes ou des configurations peut introduire une erreur subtile. Le risque n'est pas seulement la compromission volontaire. C'est aussi la propagation d'une mauvaise pratique: secret dans un script, règle pare-feu trop ouverte, dépendance non vérifiée, commande destructive, journalisation absente.
Une revue humaine reste nécessaire. Elle vérifie le résultat, mais aussi la manière dont l'agent y est arrivé.
La mesure la plus importante consiste à arrêter de voir l'agent comme une simple interface. Un agent connecté au système d'information doit être géré comme une identité non humaine. Il a un périmètre, des droits, des secrets, une durée de vie, des journaux, des propriétaires et des conditions de révocation.
Cette approche change les questions. Au lieu de demander seulement "le modèle est-il fiable ?", il faut demander: quel compte l'agent utilise-t-il ? Quels outils peut-il appeler ? Peut-il lire tous les documents ou seulement un dossier précis ? Peut-il écrire ? Peut-il envoyer vers l'extérieur ? Peut-il appeler un autre agent ? Qui valide les actions sensibles ?
Ce sont des questions d'architecture. Elles doivent être posées avant le pilote, pas après l'incident.
Le principe du moindre privilège devient central. Un agent support n'a pas besoin d'accéder à la paie. Un agent marketing n'a pas besoin de générer des clés d'administration. Un agent de développement ne devrait pas pousser en production sans revue. Plus le rôle est net, plus le rayon d'impact d'une erreur ou d'une manipulation reste limité.
Un agent bien borné est parfois moins impressionnant. Il est surtout plus exploitable en confiance par les équipes métier.
Un agent utile doit avoir assez de droits pour aider, mais jamais assez pour agir sans contrôle sur tout le système.
Limiter les sources: dossiers, bases, tickets ou dépôts réellement nécessaires à la mission.
Séparer brouillon, proposition et modification effective dans les outils métier.
Contrôler envoi d'email, webhook, publication, paiement, achat ou transfert de fichier.
Éviter les clés permanentes; privilégier jetons courts, coffre de secrets et rotation.
Documenter les appels entre agents, API, plugins et automatisations tierces.
Prévoir comment couper rapidement l'agent, ses jetons et ses connecteurs.
Un agent IA devrait passer par une revue de sécurité comme une application interne. La première étape consiste à écrire sa mission en termes simples: ce qu'il fait, ce qu'il ne fait pas, les données qu'il consulte, les actions qu'il peut déclencher et les décisions qui restent humaines. Sans ce cadrage, les permissions dérivent vite.
La deuxième étape est le test d'abus. Il ne suffit pas de vérifier que l'agent réussit les scénarios normaux. Il faut lui soumettre des documents hostiles, des demandes ambiguës, des consignes contradictoires, des fichiers contenant des instructions cachées et des cas où l'utilisateur essaie d'obtenir une action interdite. Ce test révèle les limites réelles, pas seulement la démonstration commerciale.
Un test qui ne cherche jamais à casser l'agent valide surtout le scénario idéal.
La troisième étape est la supervision. Chaque appel d'outil doit être journalisé avec le contexte utile: agent, utilisateur, outil, donnée consultée, action demandée, résultat, validation éventuelle. Si l'entreprise ne peut pas expliquer ce qu'un agent a fait hier, elle aura du mal à réagir demain.
Ce journal doit être lisible par l'équipe sécurité comme par le responsable métier. Sinon, il restera théorique.
Ces critères évitent de publier un agent utile en apparence mais fragile dès qu'il rencontre une donnée hostile.
La tâche de l'agent est-elle limitée à un cas d'usage précis ?
Impact décision : Un agent généraliste accumule vite des droits inutiles et des décisions ambiguës.
Les sources autorisées sont-elles séparées des données sensibles ?
Impact décision : La prévention des fuites commence par le périmètre documentaire.
Chaque connecteur est-il nécessaire à la mission de l'agent ?
Impact décision : Un outil inutilisé reste une surface d’abus possible.
Les actions sensibles exigent-elles une confirmation explicite ?
Impact décision : L'autonomie ne doit pas supprimer la responsabilité.
Les appels, erreurs et refus sont-ils conservés et consultables ?
Impact décision : Sans logs, l'incident devient une enquête à l'aveugle.
Peut-on désactiver l'agent et ses accès en quelques minutes ?
Impact décision : La révocation rapide limite la casse en cas de dérive.
La surveillance ne doit pas produire un flot d'alertes inutilisables. Il faut d'abord suivre les signaux qui indiquent une dérive: volume anormal d'appels, accès à une source inhabituelle, tentative répétée d'action refusée, destination externe nouvelle, changement brutal de type de tâche, outil appelé hors contexte. Ces signaux donnent une preuve terrain plus utile qu'un score abstrait.
La journalisation doit aussi permettre de relire une décision. Quand un agent recommande une action ou prépare une modification, l'équipe doit pouvoir retrouver les sources utilisées, les outils appelés et les validations obtenues. Cette traçabilité protège autant la sécurité que la qualité métier.
Enfin, il faut accepter que certains refus soient normaux. Un agent sécurisé doit parfois dire qu'il ne peut pas agir, demander une confirmation ou renvoyer vers un humain. Si tout passe toujours du premier coup, c'est souvent que les garde-fous sont trop faibles.
La supervision doit également couvrir les mises à jour. Un agent peut changer de comportement après une modification de modèle, de prompt système, de connecteur ou de base documentaire. Un test réussi en janvier ne suffit pas si l'agent reçoit en mars de nouveaux outils ou un accès plus large. Chaque changement significatif doit donc déclencher un mini-retour de recette: scénarios métier, scénarios hostiles, vérification des refus et contrôle des journaux.
Il faut enfin surveiller les coûts et les volumes. Une hausse brutale d'appels API, de requêtes vers une base sensible ou de générations longues peut signaler une dérive, une mauvaise boucle ou une tentative d'extraction. Ces indicateurs ne remplacent pas une alerte de sécurité classique, mais ils donnent souvent le premier signal faible d'un agent qui sort de son usage normal.
La priorité n'est pas d'acheter un outil de plus. Elle consiste à dresser l'inventaire des agents déjà utilisés: assistants intégrés aux suites bureautiques, agents dans les outils de support, automatisations marketing, extensions de navigateur, copilotes de code, connecteurs IA dans le CRM ou scripts internes. Beaucoup d'entreprises découvrent alors que l'agentique existe déjà dans leurs usages.
Ensuite, il faut classer ces agents par niveau de risque. Un assistant qui reformule un texte public n'a pas le même impact qu'un agent qui lit des contrats ou met à jour un compte client. Les premiers contrôles doivent cibler les agents qui manipulent des données confidentielles, appellent des outils métier ou déclenchent une action externe.
Le meilleur point de départ est souvent modeste: un registre des agents, un propriétaire par agent, une liste de connecteurs, une revue des droits, une règle de validation humaine pour les actions sensibles et un test d'injection indirecte sur les cas les plus exposés. Ce socle évite de transformer une expérimentation IA en dette de sécurité.
La relation fournisseur mérite aussi une attention spécifique. Beaucoup d'agents arrivent dans l'entreprise par une option activée dans un SaaS existant. Avant de l'utiliser sur des données internes, demandez où les données sont traitées, si elles servent à entraîner le service, comment les logs sont conservés, quelles certifications ou mesures de sécurité sont disponibles et comment couper l'accès en cas d'incident. Ce n'est pas une méfiance excessive: c'est la diligence normale pour un outil qui lit ou agit dans votre environnement.
Sur les agents développés en interne, la documentation doit rester simple mais réelle. Notez le prompt système, les outils disponibles, les comptes utilisés, les sources autorisées, les actions interdites, les validations humaines et les erreurs connues. Cette fiche évite qu'un agent devienne une boîte noire que personne n'ose modifier, mais que tout le monde continue d'utiliser.
Enfin, fixez une date de revue. Les usages IA évoluent vite, les connecteurs changent, les équipes ajoutent des automatisations et les menaces s'adaptent. Une revue trimestrielle des agents les plus sensibles suffit souvent pour supprimer un accès inutile, resserrer une permission ou repérer un workflow qui s'est éloigné de son objectif initial. La sécurité des agents IA est un cycle d'exploitation, pas une validation faite une seule fois.
Le risque baisse quand ce rendez-vous devient normal. Pas quand il dépend d'une alerte tardive ou d'un audit exceptionnel.
Les agents IA ne sont pas dangereux parce qu'ils sont intelligents. Ils deviennent risqués quand leur autonomie dépasse leur gouvernance. Tant que l'agent lit peu, agit peu et reste supervisé, le risque reste maîtrisable. Quand il lit beaucoup, agit vite et possède des droits larges, il doit être traité comme un composant critique.
Avant de déployer un agent, posez donc une question simple: si une instruction hostile arrive dans ses données, que peut-il faire concrètement ? La réponse doit tenir dans des permissions limitées, des validations humaines, des journaux lisibles et un plan de coupure clair.
Si cette réponse n'est pas disponible, l'agent n'est pas encore prêt. Il peut rester en test, aider sur des données publiques ou produire des brouillons, mais il ne doit pas recevoir de droits larges sur les outils métier.
À lire aussi

Passer de l'administration système à la cybersécurité: acquis, métiers accessibles et parcours de formation.

Un guide complet pour prioriser la cybersécurité PME: phishing, MFA, sauvegardes, postes, prestataires, incident et gouvernance sans jargon inutile.
Le compte administrateur intégré de Windows 10 peut aider au dépannage, mais il ne doit pas devenir un compte de travail permanent.
Guide pratique pour choisir un installer for Windows fiable: formats, sources, mode silencieux, tests, deploiement et desinstallation.
Guide pratique pour telecharger Windows sans risque: canal officiel, edition, licence, cycle de vie, test et tracabilite dans un parc IT.
Panne, ransomware, erreur humaine: le mê me risque Un disque qui lâ che, un ranç ongiciel qui chiffre les fichiers, un dossier supprimé par erreur: trois causes diffé rentes, un seul point commun. Sans copie.
