Plateforme SaaS
Salesloft Drift
L’incident porte sur l’environnement Drift, ses intégrations et les jetons associés.


Cybersécurité
Un incident SaaS sérieux ne commence pas toujours par une faille spectaculaire. Il peut partir d’un connecteur autorisé, d’un jeton OAuth encore valide et d’une donnée trop sensible stockée dans un outil métier. C’est ce que l’affaire Salesloft Drift rappelle aux équipes IT.
L’ancien angle, très alarmiste, mélangeait plusieurs hypothèses. La version utile consiste à séparer ce qui est confirmé publiquement, ce qui concerne les clients exposés et ce que les DSI doivent vérifier dans leurs propres environnements.
L’incident Salesloft Drift documenté publiquement repose sur l’utilisation de jetons OAuth compromis liés à l’application tierce Drift. Ces jetons ont permis à l’acteur suivi comme UNC6395 d’accéder à des instances Salesforce de clients, d’exfiltrer des données et de rechercher des secrets réutilisables dans les informations collectées.
Le point important est là : l’accès n’a pas nécessairement ressemblé à une intrusion classique. Un jeton valide peut produire des appels API qui paraissent cohérents avec l’application autorisée. Sans supervision précise des applications connectées, l’activité malveillante peut donc se cacher dans le bruit normal du SaaS. Le risque ressemble parfois à un usage attendu.
Dans ce type d’incident, l’accès paraît autorisé. C’est précisément ce qui ralentit la détection.
Le vocabulaire autour de l’incident peut prêter à confusion.
Salesloft Drift
L’incident porte sur l’environnement Drift, ses intégrations et les jetons associés.
Jetons OAuth
Un jeton valide peut contourner les réflexes centrés uniquement sur mot de passe et MFA.
Objets Salesforce
Les observations publiques citent notamment comptes, contacts, opportunités, cas et utilisateurs.
Pour une PME ou une DSI, Salesloft n’est pas seulement le nom d’un fournisseur. C’est un exemple de risque plus général : les outils marketing, support, CRM, ticketing, analytics et messagerie s’échangent des droits permanents via des connecteurs. Ces droits sont pratiques, mais ils deviennent dangereux quand ils ne sont plus inventoriés, surtout lorsque plusieurs équipes activent des intégrations pour accélérer un projet sans prévoir la revue, la révocation et la preuve de besoin dans la durée.
Le danger vient de la confiance déléguée. Une application connectée peut lire des objets CRM, synchroniser des messages, enrichir des profils ou exporter des historiques. Si son jeton est volé, le contrôle d’accès utilisateur ne suffit plus à raconter toute l’histoire.
Ce n’est pas un problème théorique. Les advisories publics décrivent une exfiltration de données depuis des objets Salesforce et une recherche de secrets comme des clés cloud, mots de passe ou jetons techniques. La question n’est donc pas seulement “quelles données client ont été lues ?”, mais aussi “quels accès secondaires ces données pouvaient-elles ouvrir ?”.
Cette question est inconfortable parce qu’elle traverse les frontières habituelles entre équipes. Le CRM appartient souvent au métier, l’intégration au marketing ops, les journaux à l’IT, les secrets aux équipes cloud, et la qualification de fuite au juridique ou à la conformité. Si chaque équipe ne regarde que son périmètre, l’entreprise peut manquer le lien entre une donnée CRM copiée et une clé technique réutilisable ailleurs.
Le risque devient alors transversal. Il faut donc une réponse transversale, pas seulement un ticket sécurité isolé.
La première vérification concerne les intégrations. Il faut identifier si Drift a été connecté à Salesforce, Google Workspace ou à d’autres applications sensibles. Ensuite, il faut savoir quels comptes, scopes et objets étaient autorisés, puis révoquer les accès qui ne sont plus nécessaires. Cette revue doit être menée vite, mais pas à l’aveugle : couper un connecteur critique sans propriétaire métier peut arrêter un processus commercial, tandis que le laisser actif sans justification prolonge le risque.
La deuxième vérification porte sur les logs API. Les exports massifs, les requêtes inhabituelles, les accès depuis des plages IP atypiques ou les jobs supprimés après exécution doivent être relus. Même si un attaquant tente de nettoyer une partie de ses traces, les journaux pertinents peuvent garder des signaux exploitables.
La troisième étape est souvent oubliée : rechercher des secrets dans les données qui auraient pu être exfiltrées. Les champs libres, tickets support, cas client, notes commerciales et historiques de conversation contiennent parfois des clés temporaires, des mots de passe transmis à tort ou des informations d’infrastructure.
Les champs libres sont rarement propres. C’est pour cela qu’ils doivent être relus avec une logique de secrets : un champ libre peut suffire à exposer une clé, détail discret jusqu’au jour où il sert de rebond.
Cette liste sert au triage initial. Elle aide à prioriser les vérifications avant de lancer l’enquête complète.
Pour approfondir ce point, consultez Clickjacking et gestionnaires de mots de passe, qui traite plus précisément de clickjacking et gestionnaires de mots de passe : le bon réglage à vérifier.
À lancer si votre environnement a utilisé Drift avec Salesforce, Workspace ou d’autres intégrations sensibles.
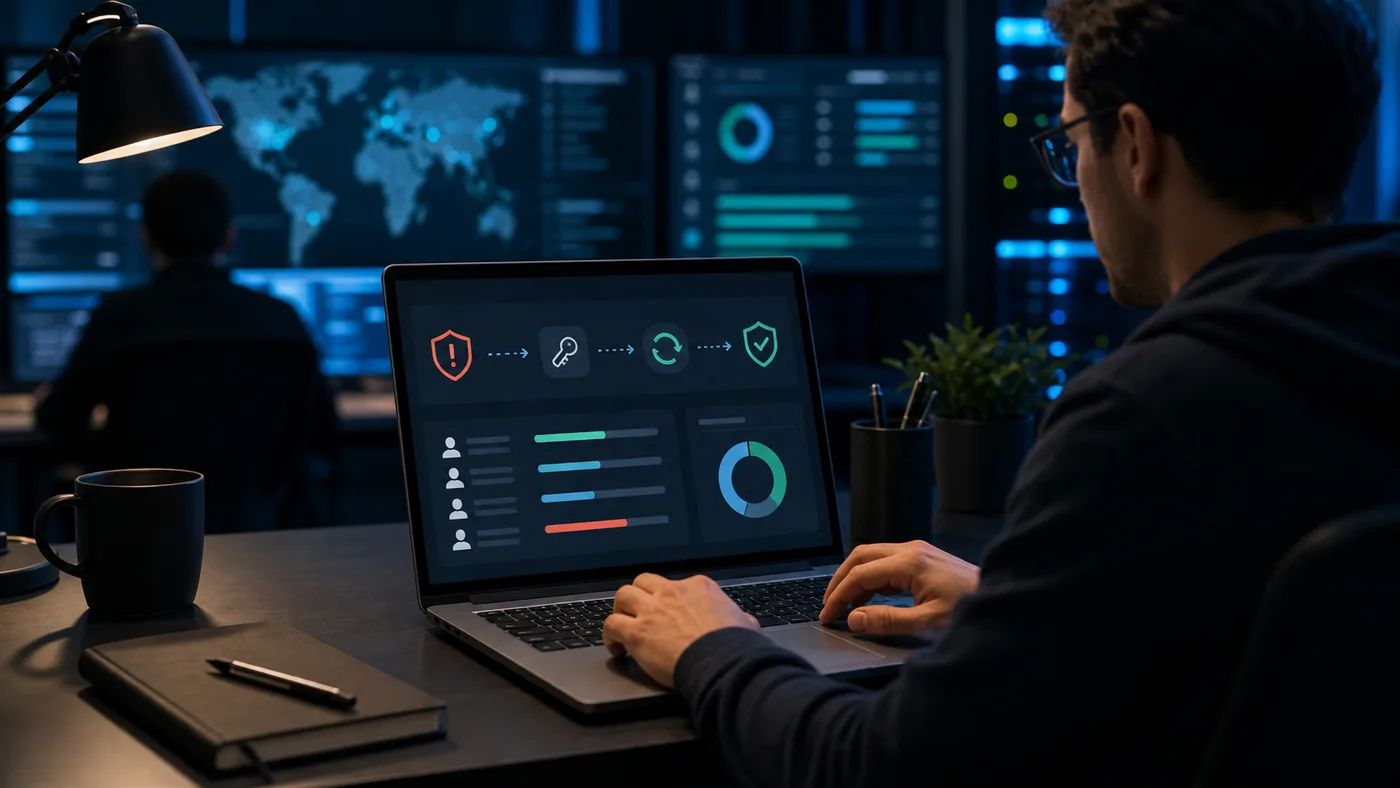
Un CRM ou un outil de support ne contient pas seulement des noms et des emails. Il peut contenir des symptômes de panne, des extraits de configuration, des identifiants partagés par erreur, des captures de logs ou des détails d’architecture. Dans un incident OAuth, cette matière devient un accélérateur, parce qu’elle peut donner à l’attaquant des indices de rebond alors même que la donnée consultée semblait d’abord commerciale ou support.
Le bon réflexe est de traiter les tickets comme une zone à risque, pas comme un simple historique de relation client. Une politique DLP légère, des modèles de réponse qui interdisent les secrets et un nettoyage régulier des champs sensibles réduisent l’effet domino après fuite.
Ce point change aussi la communication de crise. Dire “seules des données CRM ont été consultées” ne suffit pas si ces données contenaient des clés techniques ou des informations permettant un rebond. La qualification doit être menée avec les équipes sécurité, métier et juridique.
La réponse durable consiste à gouverner les applications connectées comme des comptes à privilèges. Chaque connecteur doit avoir un propriétaire, un usage documenté, des scopes limités et une date de revue. Une application abandonnée mais encore autorisée est un compte dormant sous une autre forme, avec une difficulté supplémentaire : elle ne ressemble pas à un utilisateur humain, donc elle échappe souvent aux campagnes classiques de nettoyage IAM.
| Contrôle | Objectif | Fréquence utile |
|---|---|---|
| Inventaire des apps connectées | Voir qui accède aux données SaaS | Mensuel ou après changement majeur |
| Revue des scopes OAuth | Réduire les droits trop larges | À chaque nouveau connecteur |
| Rotation des secrets | Limiter la réutilisation après fuite | Après incident et selon criticité |
| Détection des exports massifs | Repérer l’exfiltration API | Supervision continue |
Il faut aussi prévoir un scénario de révocation rapide. Si un fournisseur annonce un incident, l’entreprise doit savoir quelles intégrations couper, quels métiers prévenir et quels processus seront temporairement dégradés. Cette préparation évite de choisir entre sécurité et continuité dans l’urgence.
Une clôture d’incident doit produire des éléments vérifiables, pas seulement une décision orale.
La supervision doit dépasser la simple connexion utilisateur. Dans un incident de jeton OAuth, les signaux faibles se trouvent souvent dans les appels API : volumes anormaux, requêtes répétées sur les mêmes objets, accès hors horaire, exports successifs ou consultations de champs rarement utilisés par l’application. Cette lecture demande une base de référence, car un export légitime et un export hostile peuvent utiliser le même canal technique.
Commencez par les volumes, puis descendez vers les objets consultés. Cette lecture évite de se perdre dans chaque événement isolé.
Les équipes doivent aussi regarder les changements d’applications connectées. Une autorisation récemment modifiée, un scope élargi ou une intégration réactivée après une longue période d’inactivité mérite une vérification. Ce n’est pas toujours malveillant, mais c’est exactement le type de mouvement qu’une gouvernance SaaS doit rendre visible.
Pour les environnements les plus critiques, ces contrôles gagnent à être rapprochés du SIEM ou d’un outil CASB/SSPM. L’objectif n’est pas de centraliser tous les logs par principe, mais de corréler application connectée, compte de service, volume d’export et type de données accédées.
Sans cette corrélation, chaque alerte reste isolée. L’équipe voit des événements, mais pas encore le scénario d’exfiltration.
Chaque connecteur SaaS devrait avoir un propriétaire métier et un propriétaire technique. Le premier justifie l’usage; le second valide les droits accordés. Sans cette double responsabilité, les intégrations restent souvent en place parce que personne n’ose les désactiver.
La revue doit répondre à quatre questions simples : qui utilise l’intégration, quelles données sont lues, quels droits sont accordés et que se passe-t-il si on coupe l’accès ? Si personne ne peut répondre, le connecteur est déjà un risque de continuité autant qu’un risque de sécurité.
Cette règle paraît basique, mais elle change la posture de contrôle. Un connecteur n’est plus “autorisé une fois pour toutes”; il devient un actif à gouverner, avec un propriétaire, une justification, une preuve d’usage et une limite de droits. Cette logique réduit le nombre d’exceptions invisibles qui s’accumulent au fil des projets SaaS.
Elle oblige aussi à accepter un compromis opérationnel : certains connecteurs très utiles garderont des droits larges, parce qu’ils structurent réellement un processus métier. Dans ce cas, l’objectif n’est pas de les supprimer par principe, mais de les rendre visibles, surveillés et révocables rapidement. La sécurité gagne quand une exception est nommée, mesurée et réévaluée, pas quand elle disparaît dans une liste d’autorisations que personne ne relit.
Cette gouvernance évite aussi les réactions excessives. Après un incident public, tout couper sans analyse peut bloquer les équipes commerciales ou support. À l’inverse, attendre une confirmation parfaite peut laisser un jeton exposé trop longtemps. Une cartographie à jour permet un arbitrage plus calme, avec une décision qui tient compte des droits, du métier, du risque réel et du délai de remise en service.
Un connecteur sans propriétaire doit devenir une exception temporaire, jamais une dette permanente laissée hors radar.
Cette règle doit être écrite. Sinon, elle dépendra de la mémoire des équipes.
À lire ensuite, steam on linux, consacré à steam on linux, ce qu’il faut vérifier avant de jouer.
Un incident SaaS ne se clôt pas au moment où le fournisseur annonce une remédiation. Pour l’entreprise cliente, il faut pouvoir démontrer que les jetons concernés ont été révoqués, que les applications connectées ont été revues, que les logs ont été analysés et que les secrets potentiellement exposés ont été remplacés.
La clôture doit être prouvable, compréhensible et datée. Sinon, l’incident reviendra au prochain audit comme une zone grise.
La clôture doit aussi inclure une preuve métier. Si des objets CRM ont été consultés, il faut savoir quelles familles de données étaient présentes : contacts, opportunités, cas support, notes commerciales, champs libres. Cette qualification aide à décider si une notification client, juridique ou interne est nécessaire.
Le dernier point est documentaire. Gardez la liste des actions, les dates de rotation, les connecteurs supprimés, les exceptions acceptées et les zones non couvertes par les logs. Ce dossier évite de refaire l’enquête trois mois plus tard, quand un audit ou un client demandera ce qui a réellement été vérifié.
Le dossier de clôture protège l’équipe. Il évite les débats tardifs sur ce qui a été fait.
Ils donnent une preuve exploitable avant même la fin de l’enquête fournisseur.

Cherchez les exports, les volumes inhabituels et les accès par application connectée.

Associez chaque connecteur à un propriétaire, un usage actif et des scopes justifiés.
Il serait tentant de résumer l’incident à “Salesforce a été piraté” ou “un chatbot a tout exposé”. Ces formulations sont trop imprécises. Les sources publiques insistent plutôt sur l’abus de jetons OAuth associés à une application tierce et sur l’exploitation des accès qu’ils donnaient.
Il ne faut pas non plus croire que la MFA règle seule ce type de cas. La MFA protège une authentification utilisateur, mais un jeton applicatif déjà émis peut survivre à cette logique tant qu’il n’est pas révoqué ou contrôlé. C’est la raison pour laquelle la gestion des applications connectées doit rejoindre les pratiques IAM classiques.
Cette nuance est importante pour la gouvernance. Si l’on accuse la mauvaise couche technique, les actions correctives partent dans la mauvaise direction : durcissement des mots de passe, communication trop générale, revue utilisateur classique, mais pas de contrôle sérieux des connecteurs, des scopes, des journaux API et des secrets disséminés dans les outils métiers. Le résultat peut donner une impression de réaction rapide sans réduire le risque qui a permis l’abus initial.
La nuance protège aussi la relation avec les métiers. Une équipe commerciale ou support acceptera plus facilement une coupure temporaire si elle comprend que le problème vient d’un droit applicatif précis, pas d’une suspicion générale sur son outil. Cette précision évite les débats inutiles, accélère les arbitrages et aide à reconstruire une intégration plus limitée après la phase d’urgence.
La pédagogie fait partie de la remédiation. Sans elle, les mêmes droits reviennent au prochain projet urgent.
La priorité n’est pas d’attendre le prochain incident fournisseur, mais de cartographier les accès SaaS qui existent déjà. Les outils métiers accumulent des permissions au fil des projets, des campagnes et des intégrations rapides. Sans revue, personne ne sait vraiment quelle application peut lire quoi.
Dans une PME, cette cartographie peut commencer simplement : export des applications OAuth, classement par outil métier, vérification du propriétaire, puis suppression des connecteurs orphelins. Ce n’est pas encore une gouvernance parfaite, mais c’est déjà une réduction de surface d’attaque mesurable. Le plus important est de transformer cette revue en routine, pas en réaction exceptionnelle après une alerte fournisseur.
Pour une équipe IT, le plan pragmatique tient en trois actions : inventorier les connecteurs, réduire les scopes et surveiller les exports. Si un incident survient, cette base permet de répondre vite, de limiter les dégâts et de prouver ce qui a réellement été exposé.
Ce trio reste volontairement simple. Il doit pouvoir être lancé avant même qu’un audit complet soit planifié.
La communication interne doit rester aussi précise que la remédiation. Les métiers ont besoin de savoir quels outils sont coupés, combien de temps, et quelles données sont en cours d’analyse. Les messages vagues créent de la panique; les messages trop rassurants créent de la défiance si l’enquête évolue. Une bonne note interne distingue donc l’impact confirmé, l’impact encore en cours d’analyse, les actions déjà menées et les comportements attendus des équipes.
La prochaine action réaliste consiste à extraire aujourd’hui la liste des applications connectées critiques, puis à supprimer celles que personne ne peut justifier avec un propriétaire identifié et un usage encore actif.
Ce premier inventaire n’a pas besoin d’être parfait. Il doit surtout commencer : un export CSV, une réunion courte et trois décisions de révocation valent mieux qu’une cartographie idéale jamais lancée par manque de temps.
La bonne mesure est celle qui réduit un accès réel dès cette semaine, sans attendre une refonte IAM complète.
Pour approfondir ce point, consultez Agents IA et cybermenaces : sécuriser l'autonomie, qui traite plus précisément de agents ia et cybermenaces : sécuriser l'autonomie avant l'incident.
À lire aussi

Un guide complet pour prioriser la cybersécurité PME: phishing, MFA, sauvegardes, postes, prestataires, incident et gouvernance sans jargon inutile.
Le compte administrateur intégré de Windows 10 peut aider au dépannage, mais il ne doit pas devenir un compte de travail permanent.
Guide pratique pour choisir un installer for Windows fiable: formats, sources, mode silencieux, tests, deploiement et desinstallation.
Guide pratique pour telecharger Windows sans risque: canal officiel, edition, licence, cycle de vie, test et tracabilite dans un parc IT.
Panne, ransomware, erreur humaine: le mê me risque Un disque qui lâ che, un ranç ongiciel qui chiffre les fichiers, un dossier supprimé par erreur: trois causes diffé rentes, un seul point commun. Sans copie.
Effectuer une expertise indé pendante du vote é lectronique est devenu une né cessité absolue pour toute organisation cherchant à pré server l’ inté grité de ses processus.
