Maîtriser la commande mv sous Linux: guide pratique et exemples concrets
9 février 202625 min de lectureHanaé Aubert
La commande mv représente l’un des outils fondamentaux de tout utilisateur Linux, qu’il soit administrateur système, développeur ou simple utilisateur. Cet outil permet non seulement de déplacer des fichiers et des répertoires d’une localisation à une autre, mais aussi de les renommer en une seule opération, ce qui en fait un élément incontournable du quotidien dans le terminal Linux. Comprendre ses subtilités et ses options avancées transforme la gestion des fichiers en une tâche fluide et efficace.
Pour approfondir ce point, consultez Sudo sous Linux, méthode fiable pour administrer, qui traite plus précisément de sudo sous linux, méthode fiable pour administrer sans ouvrir la porte root.
En bref
✓️ La commande mv permet de déplacer ou renommer fichiers et dossiers rapidement, sans dupliquer les données
✓Utilisation de motifs (wildcards) et combinaisons avec d’autres commandes pour des déplacements massifs et sélectifs
✓Options de sécurité essentielles (-i, -n, -u) pour éviter l’écrasement accidentel et garantir des scripts fiables
✓️ Pièges courants : écrasement silencieux, confusion chemins relatifs/absolus, problèmes de permissions et de noms avec espaces
✓mv est un outil clé dans l’automatisation, l’archivage, la gestion de versions et l’orchestration de workflows sous Linux
YouTube
Vidéo utile sur le sujet
Ce contenu externe reste bloqué par défaut. Vous pouvez l'activer si vous acceptez le chargement des médias externes.
Fonctionnement fondamental de la commande mv et ses principes de base
Réponse directe
La commande mv déplace ou renomme des fichiers et des répertoires en modifiant simplement leur référence dans le système de fichiers, sans copier le contenu, ce qui rend l’opération rapide et efficace, particulièrement au sein de la même partition.
La commande mv, qui signifie littéralement « move », fonctionne selon un principe simple mais puissant : elle effectue une opération de « couper-coller » plutôt que de « copier-coller ». Lorsqu’un fichier est déplacé d’une source vers une destination, son contenu n’est pas dupliqué sur le disque dur, mais son référencement est simplement mis à jour dans la structure du système de fichiers. Cela signifie que le fichier original est supprimé de son emplacement initial et réapparaît à la destination spécifiée.
Cette distinction est cruciale pour comprendre pourquoi mv est bien plus rapide que la commande cp (copie), surtout lorsqu’il s’agit de fichiers volumineux ou de déplacements entre des partitions du même système de fichiers. La syntaxe basique reste extrêmement accessible : mv source destination. Cette simplicité apparente cache cependant une flexibilité remarquable qui permet d’accomplir des tâches complexes de gestion de fichiers.
Disponible nativement sur toutes les distributions Linux—qu’il s’agisse de Debian, Ubuntu, Rocky Linux, CentOS ou toute autre variante—la commande mv maintient une cohérence absolue dans son comportement et ses options. Cette uniformité fait partie de la philosophie Unix qui privilégie la prévisibilité et la portabilité des scripts et des workflows entre différents environnements.
La syntaxe élémentaire et ses paramètres essentiels
La structure de base de la commande mv s’articule autour de trois éléments : la commande elle-même, le chemin source et le chemin de destination. Lorsqu’il s’agit de déplacer un fichier vers un répertoire, le répertoire cible doit être spécifié sans ambiguïté. Par exemple, mv fichier.txt /tmp/ déplace le fichier dans le répertoire /tmp en conservant son nom original.
Pour les répertoires, la syntaxe reste identique, bien que la convention recommande d’ajouter un slash final au chemin source pour indiquer clairement qu’il s’agit d’un dossier : mv dossier/ /destination/. Cette clarté facilite la lecture des scripts et aide à prévenir les confusions lors de manipulations en ligne de commande, particulièrement lorsque la compréhension rapide de l’intention est primordiale.
Les chemins peuvent être spécifiés de manière absolue (commençant par /) ou relative (par rapport au répertoire courant). L’utilisation de chemins absolus est généralement préférable dans les scripts de production, tandis que les chemins relatifs conviennent davantage aux manipulations interactives où le contexte du répertoire courant est connu.
Astuce
Pour déplacer plusieurs fichiers d’un coup, listez-les tous avant le nom du dossier de destination. Exemple : mv .jpg ./photos/ déplacera toutes les images JPEG dans le dossier « photos ».
Comprendre la commande mv sous Linux permet de déplacer et renommer des fichiers ou dossiers avec rapidité et sécurité dans le terminal Linux
Déplacement de fichiers et répertoires : stratégies pratiques et exemples concrets
Réponse directe
La commande mv permet de déplacer plusieurs fichiers ou répertoires en une seule commande, préservant leur structure interne, et d’utiliser des caractères génériques pour des déplacements massifs ou sélectifs selon des critères de nommage.
Le déplacement de fichiers individuels constitue le cas d’usage le plus élémentaire de la commande mv, mais cette apparente simplicité cache des subtilités importantes selon le contexte d’exécution. Un développeur travaillant localement sur sa machine n’aura pas les mêmes préoccupations qu’un administrateur système gérant des milliers de fichiers sur un serveur de production où chaque opération peut avoir des implications significatives.
Pour aller plus loin
Pour compléter cette lecture, Base64 en ligne de commande, encoder sans apporte des repères utiles sur base64 en ligne de commande, encoder sans confondre avec chiffrer.
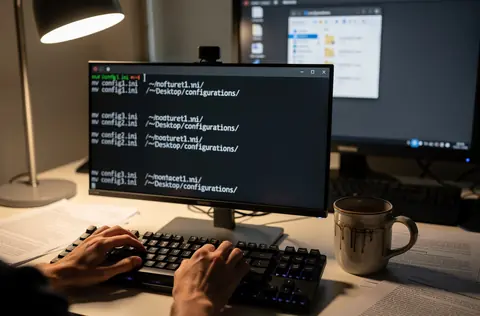
Considérons un scénario courant : un utilisateur souhaite organiser ses fichiers de développement. Il dispose de plusieurs fichiers de configuration éparpillés dans son répertoire personnel et souhaite les centraliser. Plutôt que d’exécuter plusieurs commandes mv individuellement, la commande mv config1.ini config2.ini config3.ini ./configurations/ permet de tous les déplacer en une seule opération vers le répertoire « configurations ».
Les répertoires complets, avec toute leur hiérarchie interne, peuvent également être déplacés sans aucune complication supplémentaire. Un dossier contenant des sous-dossiers, des fichiers imbriqués et toute autre structure organisationnelle est préservé intégralement lors du déplacement. Cette préservation de l’arborescence rend possible la réorganisation complète de projets volumineux sans risque de perte d’information structurelle.
Déplacement en masse avec les motifs de correspondance
L’utilisation des caractères génériques ou « wildcards » transforme la commande mv en outil de déplacement massif particulièrement efficace. Le symbole astérisque (*) représente n’importe quelle séquence de caractères, tandis que le point d’interrogation (?) représente un seul caractère. Cette flexibilité permet de cibler des fichiers selon des critères sophistiqués sans énumérer individuellement chaque élément.
Imaginons un scénario où un serveur web doit archiver tous les fichiers journaux du mois précédent. Plutôt que d’identifier manuellement chaque fichier, la commande mv logs_2026_*.txt /archive/ déplace tous les fichiers dont le nom commence par « logs_2026_ » et se termine par « .txt ». Cette approche gagne énormément de temps lors de la gestion de grands volumes de données.
Un cas d’usage particulièrement intéressant concerne le déplacement du contenu complet d’un répertoire sans déplacer le répertoire lui-même. La commande mv source/* destination/ extrait tous les éléments du répertoire source et les place dans la destination, laissant le répertoire source vide. Cela s’avère indispensable lorsqu’on souhaite réorganiser une hiérarchie de fichiers sans encombrer la destination avec un répertoire supplémentaire.
Exclusion sélective lors des déplacements multiples
📌 Parfois, le défi ne consiste pas à déplacer des fichiers spécifiques, mais plutôt à déplacer tout sauf quelques exceptions. Bien que la commande mv ne possède pas d’option native pour les exclusions, une combinaison intelligente avec d’autres commandes permet de contourner cette limitation. La technique la plus courante utilise l’option –ignore de la commande ls pour filtrer les fichiers à exclure.
La construction mv $(ls –ignore=fichier_exclu.txt –ignore=autre_fichier.txt) /destination/ fonctionne en substituant le résultat de la commande ls filtré dans l’argument de mv. Cette approche, bien qu’un peu complexe en apparence, s’avère extrêmement puissante pour les opérations de maintenance systématique où certains fichiers doivent rester en place tandis que leurs homologues sont archivés.
Une alternative plus robuste utilise des expressions régulières avec des commandes comme find associées à mv via la redirection. Cette méthode offre une granularité encore plus fine dans la sélection des fichiers à déplacer, permettant des critères basés sur la date de modification, la taille, les permissions ou n’importe quel autre attribut de fichier accessible dans le système de fichiers.
Pour approfondir ce point, consultez Premiers pas réussis avec la commande Curl, qui traite plus précisément de premiers pas réussis avec la commande curl : guide pratique pour débutants.
Astuce
Si vous souhaitez renommer un fichier tout en le déplaçant, il suffit d’utiliser mv ancien_nom.txt nouveau_dossier/nouveau_nom.txt en une seule commande.
YouTube
Vidéo utile sur le sujet
Ce contenu externe reste bloqué par défaut. Vous pouvez l'activer si vous acceptez le chargement des médias externes.
Renommage de fichiers et répertoires : au-delà de la simple modification de nom
Réponse directe
Renommer un fichier ou un répertoire avec mv consiste simplement à spécifier un nouveau nom en destination, le processus se limitant à la modification de la métadonnée du nom dans le système de fichiers, sans altérer le contenu.
Le renommage constitue une application souvent méconnue mais extrêmement utile de la commande mv. Conceptuellement, renommer un fichier n’est rien d’autre que le déplacer vers le même répertoire avec un nom différent. Cette perspective unififiée simplifie considérablement la compréhension de la commande et permet de traiter renommage et déplacement comme des variations d’une même opération fondamentale.
Pour renommer un fichier, il suffit d’utiliser mv ancien_nom.txt nouveau_nom.txt. Cette opération demeure extrêmement rapide puisqu’elle ne modifie que la métadonnée du nom dans le système de fichiers, sans toucher au contenu réel du fichier stocké sur le disque. Même pour des fichiers de plusieurs gigabytes, l’opération s’effectue en une fraction de seconde.
Ce mécanisme devient particulièrement intéressant pour implémenter des conventions de nommage ou rectifier des erreurs de dénomination à grande échelle. Un administrateur système gérant des milliers de fichiers journaux pourrait renommer tous les fichiers d’une année à l’autre simplement en ciblant le motif correspondant. Une convention courante consiste à ajouter un suffixe « .old » ou « .bak » aux anciennes versions, ce qui se réalise aisément avec mv fichier.conf fichier.conf.old.
Renommage structuré et gestion des versions
🔄 Dans les environnements de production, renommer correctement les fichiers revêt une importance stratégique. Les fichiers de configuration, les sauvegardes et les fichiers journaux bénéficient tous d’une nomenclature cohérente et versionnée. La commande mv facilite cette gestion en permettant des renommages rapides qui reflètent l’état temporel ou la fonction du fichier.
Considérons un serveur d’application qui génère un fichier de configuration à chaque déploiement. Pour maintenir l’historique des configurations précédentes, chaque nouvelle version est d’abord testée sous un nom temporaire, puis une fois validée, elle remplace la configuration active. La séquence mv config.ini config.ini.backup && mv config.ini.new config.ini effectue cette transition atomiquement, s’assurant que la configuration de secours est préservée avant l’activation de la nouvelle.
Le renommage des répertoires suit exactement la même logique. mv ancienne_version/ nouvelle_version/ restructure les projets, archive les environnements temporaires ou organise les stockages hiérarchiquement. Cette flexibilité rend possible des réorganisations majeures de structures de répertoires sans perturbation de service, particulièrement lorsqu’elle est combinée avec des vérifications de dépendances et des tests préalables.
Conseil
Pour éviter d’écraser accidentellement un fichier existant, ajoutez l’option -i à mv. Vous devrez alors confirmer chaque écrasement, limitant le risque de perte de données.
Options avancées et sécurité : maîtriser les modificateurs essentiels
Réponse directe
Parmi les options essentielles de mv : -i demande confirmation avant écrasement, -n préserve les fichiers existants, -u ne déplace que si la source est plus récente, -v affiche les fichiers déplacés, -f force l’opération sans confirmation.
La commande mv propose plusieurs options qui modifient son comportement par défaut, offrant au programmeur et à l’administrateur un contrôle granulaire sur comment les fichiers sont traités. Ces modificateurs deviennent indispensables dans les scripts de production où une exécution imprévisible pourrait entraîner des pertes de données ou des incohérences.
Le comportement par défaut de mv consiste à écraser silencieusement le fichier de destination s’il existe déjà. Cette « non-intervention » peut sembler efficace, mais elle présente un risque considérable : un fichier critique pourrait être accidentellement remplacé sans aucune notification. Pour cette raison, les scripts professionnels intègrent systématiquement des options de sécurité qui préviennent ces écrasements involontaires.
🔧 Option
Description
Cas d’usage typique
-i (interactive)
Demande une confirmation avant d’écraser un fichier existant
Manipulations manuelles sensibles où on souhaite valider chaque action
-n (no-clobber)
N’écrase jamais les fichiers existants, annule l’opération en silence
Scripts automatisés où les fichiers existants doivent être préservés
-u (update)
Déplace seulement si le fichier source est plus récent que la destination
Synchronisation conditionnelle basée sur la date de modification
-v (verbose)
Affiche chaque fichier déplacé
Débogage et suivi des opérations pour vérification
-f (force)
Force le déplacement sans demander de confirmation (écrase sans hésiter)
Scripts non interactifs où les décisions sont prédéfinies
✅ L’option -i (interactive) s’avère particulièrement utile lors de manipulations manuelles impliquant des fichiers sensibles. Lorsqu’un conflit potentiel se présente, la commande affiche un message et attend une réponse explicite de l’utilisateur. Cette barrière psychologique et fonctionnelle prévient les catastrophes accidentelles qui pourraient autrement se produire lors du travail en terminal, surtout lorsque l’attention se disperse.
Pour approfondir ce point, consultez Trouver son adresse IP publique sous Linux, qui traite plus précisément de trouver son adresse ip publique sous linux sans se tromper.
À l’inverse, l’option -n (no-clobber) adopte une approche prudente en refusant catégoriquement d’écraser les fichiers existants. Si un fichier de destination existe déjà, l’opération est silencieusement annulée sans notification. Cette option convient particulièrement aux scripts où l’existence d’un fichier de destination signifie que l’opération a déjà été effectuée ou qu’une intervention manuelle est nécessaire.
Stratégies d’update et synchronisation conditionnelle
⏰ L’option -u (update) introduit une logique conditionnelle basée sur les métadonnées de fichier. Elle compare la date de modification du fichier source avec celle de la destination et n’effectue le déplacement que si la source est plus récente. Cette approche s’avère précieuse lors de la synchronisation de fichiers entre des emplacements différents, notamment dans les processus de sauvegarde ou de mise à jour de configuration.
Imaginons un scénario où un script système exécute régulièrement le déplacement de fichiers journaux vers une archive. Avec l’option -u, les anciens fichiers journaux qui auraient déjà été traités ne seront pas redéplacés, évitant ainsi les opérations inutiles qui surchargeraient le système. La commande mv -u logs_ancien.txt /archive/ effectue cette vérification intelligente avant de procéder.
La combinaison de plusieurs options offre une sécurité maximale. Par exemple, mv -u -n fichier.txt /destination/ combine la mise à jour conditionnelle avec le refus d’écrasement, créant un comportement extrêmement prévisible et sûr. Cette rigueur devient fondamentale dans les environnements de production où les erreurs coûtent cher et où la prévisibilité des opérations de manipulation de fichiers est une exigence non négociable.
Verbosité et debugging pour les opérations massives
🔍 L’option -v (verbose) transforme une opération silencieuse en une série de confirmations visuelles. Chaque fichier déplacé est annoncé, permettant une vérification en temps réel de ce qui se produit. Cette traçabilité devient essentielle lors du débogage de scripts ou lors de vérification d’opérations massives de déplacement de fichiers.
Lors du traitement de milliers de fichiers, l’absence de feedback peut laisser l’utilisateur incertain quant à la progression réelle. L’option -v fournit cette information, permettant d’identifier rapidement si le script fonctionne correctement ou s’il rencontre des fichiers problématiques. La sortie verbose peut également être redirigée vers un fichier journal pour création d’un audit permanent : mv -v *.log /archive/ > deplacement.log.
Explication
Attention : mv écrase sans avertissement les fichiers de destination existants, sauf si vous utilisez -i (confirmation) ou -n (refus d’écrasement). Privilégiez ces options dans vos scripts pour plus de sécurité.
Pièges courants et bonnes pratiques pour éviter les désastres de déplacement
Réponse directe
Les principaux risques avec mv sont l’écrasement silencieux de fichiers, les erreurs de chemin, la gestion incorrecte des liens symboliques, les permissions insuffisantes et les problèmes avec les espaces ou caractères spéciaux dans les noms de fichiers.
Même les utilisateurs expérimentés de Linux commettent occasionnellement des erreurs avec la commande mv, souvent avec des conséquences fâcheuses. Ces pièges, bien que prévisibles, restent suffisamment insidieux pour justifier une discussion détaillée. Comprendre ces erreurs courantes transforme la gestion des fichiers en une activité sûre et contrôlée.
Le premier piège concerne l’écrasement accidentel de fichiers. Par défaut, mv écrase sans hésiter et sans demander confirmation. Un utilisateur inattentif pourrait facilement perdre des fichiers importants avec une commande innocemment formulée. La formation et l’utilisation systématique d’options de sécurité constituent la première ligne de défense contre ce problème.
Le deuxième piège réside dans la confusion entre chemins relatifs et absolus. Un fichier déplacé vers /tmp/ suit un chemin absolue sans ambiguïté, mais un déplacement vers ../backup/ dépend entièrement du répertoire courant. Les scripts non portables résultent souvent de cette confusion, fonctionnant correctement lorsque l’utilisateur se trouve dans le répertoire attendu mais échouant mystérieusement ailleurs.
Pour approfondir ce point, consultez scp commande linux, qui traite plus précisément de commande scp linux pour transférer des fichiers en sécurité.
🚫 Écrasement silencieux : Toujours utiliser -i ou -n en scripts de production pour prévenir les suppressions accidentelles
📍 Chemins mal spécifiés : Privilégier les chemins absolus dans les scripts, réserver les chemins relatifs aux manipulations interactives
🔗 Liens symboliques : Comprendre que mv déplace le lien lui-même, pas la cible, sauf comportement système différent
💾 Permissions insuffisantes : Vérifier les permissions du répertoire destination avant d’exécuter, particulièrement pour les chemins système
⚡ Chemins avec espaces : Toujours encadrer les noms de fichiers contenant des espaces entre guillemets pour éviter les interprétations erronées
🔄 Opérations entre systèmes de fichiers : Les déplacements entre partitions différentes sont plus lents qu’au sein d’une même partition
Sécurisation des scripts avec les validations préalables
⚠️ Les administrateurs système expérimentés entourent systématiquement leurs opérations critiques de validations préalables. Avant de déplacer un fichier, on vérifie son existence, ses permissions, l’espace disponible à la destination et d’autres conditions susceptibles d’affecter le succès de l’opération. Ces validations transforment des scripts fragiles en outils robustes et fiables.
Un script de production exemplaire pourrait ressembler à ceci : il commence par vérifier l’existence du fichier source avec test -f, s’assure que le répertoire destination existe et possède les permissions adéquates, puis exécute l’opération mv avec l’option verbale pour audit. Si une validation échoue, le script affiche un message d’erreur explicite et s’arrête plutôt que de poursuivre avec des données potentiellement corrompues.
La redirection des sortie et erreur vers des fichiers journaux permet une analyse post-mortem si quelque chose s’est produit de manière inattendue : mv -v fichier.txt destination/ >> journal_deplacement.log 2>> journal_erreurs.log. Cette approche crée un trail d’audit permanent documentant exactement ce qui s’est passé, invaluable pour le débogage et la conformité réglementaire.
Gestion des caractères spéciaux et des cas limites
Les noms de fichiers contenant des espaces, des caractères spéciaux ou des caractères de contrôle constituent un cas limite fréquent dans les systèmes Linux hétérogènes. La commande mv gère ces cas, mais uniquement si les chemins sont correctement protégés. Les guillemets doubles autour du chemin garantissent que les espaces et la plupart des caractères spéciaux sont interprétés littéralement.
Un fichier nommé « mon fichier important.txt » avec des espaces doit être manipulé comme mv « mon fichier important.txt » destination/. L’oubli des guillemets entraînerait que la commande interprète le nom comme plusieurs arguments distincts, produisant un comportement totalement inattendu. Les scripts robustes utilisent systématiquement des guillemets pour tous les chemins de fichiers, même s’ils ne contiennent pas de caractères spéciaux, pour assurer une portabilité maximale.
Les caractères génériques aussi peuvent créer de la confusion. Si on souhaite littéralement déplacer un fichier dont le nom contient un astérisque ou un point d’interrogation (ce qui est techniquement possible bien que déconseillé), il faut échapper ces caractères avec un antislash : mv « fichier*.txt » destination/. Cette subtilité rappelle pourquoi les conventions de nommage cohérentes et sans caractères problématiques constituent une bonne pratique universelle.
Bon à savoir
La commande find couplée à mv permet d’automatiser le déplacement de fichiers selon des critères précis (date, nom, taille, etc.), rendant la gestion de grandes volumétries bien plus efficace.
Applications avancées dans le contexte du scripting et de l’automatisation système
Réponse directe
Dans les scripts d’automatisation, mv est utilisé pour archiver, organiser ou synchroniser des fichiers à grande échelle, souvent en combinaison avec find, test ou rsync pour garantir la cohérence, la sécurité et l’efficacité des opérations de gestion de fichiers.
Au-delà des cas d’usage simples, la commande mv devient un outil puissant au sein de scripts d’automatisation complexes. Ces scripts orchestrent des opérations massives de gestion de fichiers, synchronisent des données entre serveurs, implémentent des politiques de rétention et accomplissent mille autres tâches que les administrateurs modernes délèguent à l’automatisation plutôt que de les effectuer manuellement.
Un cas d’usage emblématique concerne l’archivage automatisé de fichiers journaux. Les serveurs génèrent des gigabytes de fichiers journaux quotidiennement. Sans automatisation, le disque s’emplit rapidement, dégradant les performances. Les scripts utilisant mv associé à find déplacent automatiquement les fichiers journaux anciens vers des répertoires d’archive ou des emplacements externes, maintenant les disques de production à des niveaux de remplissage sains.
La commande find /var/log -name « *.log » -mtime +30 -exec mv {} /archive/ ; localise tous les fichiers journaux modifiés il y a plus de 30 jours et les déplace vers l’archive. Cette approche combine la puissance de recherche de find avec la capacité de déplacement de mv, créant une solution d’archivage entièrement automatisée et extrêmement flexible.
Pour approfondir ce point, consultez tar.gz linux, qui traite plus précisément de fichier tar.gz sous linux, les commandes utiles sans erreur.
Intégration dans les pipelines de traitement de données
🔀 Dans les environnements de big data et de traitement batch, mv joue souvent un rôle crucial dans l’orchestration du flux de travail. Les fichiers transitent par plusieurs étapes de traitement, chaque étape les déplaçant vers des répertoires différents indiquant leur état actuel dans le pipeline. Cette approche, appelée « state machine » ou « machine à états », permet de suivre précisément la progression de chaque fichier.
Un système de traitement de fichiers d’images pourrait implémenter ce flux : les images brutes arrivent dans /incoming/, sont traitées et déplacées vers /processing/, puis vers /validated/ après validation qualité, enfin vers /archive/ après intégration dans la base de données. Cette organisation claire facilite le débogage, l’audit et la récupération en cas d’erreur.
La combinaison de mv avec d’autres commandes comme test, grep et wc permet la création de scripts de validation sophistiqués qui ne déplacent les fichiers vers l’étape suivante que s’ils satisfont des critères stricts. Cette rigueur garantit que seules les données conformes progressent dans le pipeline, prévenant les erreurs propagées qui pourraient compromettre l’intégrité de tout le traitement.
Orchestration multi-serveurs et synchronisation distribuée
Dans les architectures distribuées modernes, les fichiers sont souvent répartis entre plusieurs serveurs. La commande mv locale à elle-seule ne peut pas déplacer des fichiers entre machines, mais combinée avec scp, rsync ou d’autres outils de transfert réseau, elle devient partie d’une solution globale de gestion de fichiers distribuée. Un administrateur gère les fichiers locaux avec mv tandis qu’un script orchestrateur synchronise les changements vers les serveurs pairs.
Les systèmes de monitoring de fichiers comme inotify sous Linux détectent les changements de fichiers et peuvent déclencher des scripts qui utilisent mv pour déplacer les fichiers modifiés vers des répertoires de traitement ou d’archivage. Cette approche événementielle évite les vérifications périodiques coûteuses, rendant les systèmes plus responsifs et moins consommateurs de ressources.
Pour garantir la cohérence des données dans ces architectures distribuées, les scripts utilisent systématiquement mv -n pour éviter les écrasements accidentels lors de conditions de concurrence. Chaque serveur n’accepte les fichiers que s’ils n’existent pas déjà, prévenant les conflits qui pourraient autrement corrompre les données ou créer des incohérences système.
Implémentation de stratégies de sauvegarde et de roulement de fichiers
💾 Les sauvegardes et la gestion du cycle de vie des fichiers critiques représentent des domaines où mv brille particulièrement. Une stratégie courante consiste à maintenir plusieurs versions récentes d’un fichier en effectuant un roulement : la version la plus ancienne est supprimée, chaque version plus récente est renommée à la version antérieure, et la nouvelle version reçoit le nom de version actuelle.
Un exemple classique : mv config.ini.2 config.ini.3 && mv config.ini.1 config.ini.2 && mv config.ini config.ini.1 && cp config.ini.new config.ini effectue un roulement de trois versions conservant le bénéfice de deux précédentes sauvegardes au cas où il serait nécessaire de revenir à une version antérieure. Cette approche minimale occupe peu d’espace tout en fournissant une protection adéquate contre les corruptions transitoires.
Dans les contextes plus élaborés, des scripts implémentent des stratégies de rétention basées sur la date : les fichiers sont automatiquement promus à différents niveaux d’archivage en fonction de leur âge. Les fichiers du jour restent sur le stockage rapide, ceux de la semaine passée sont déplacés sur stockage standard, et ceux de plus de trois mois vers une archive économique. La commande mv effectue ces transitions sans nécessiter de nouveau traitement des données, préservant à la fois le temps d’exécution et l’intégrité des données.
L’intemporalité de la commande mv dans l’écosystème Linux démontre l’importance d’outils fondamentaux bien conçus qui perdurent au-delà des tendances technologiques éphémères. Que ce soit pour des tâches simples de réorganisation quotidienne de fichiers ou pour des opérations d’automatisation système complexes, cette commande reste un pilier incontournable de l’administration Linux moderne en 2026. La maîtrise de ses mécanismes, de ses options et de ses pièges transforme les administrateurs et développeurs en opérateurs efficaces capables d’accomplir avec assurance les tâches critiques de gestion de fichiers.
Hanaé Aubert accompagne les entreprises sur leurs enjeux numériques. Ses contenus visent un public professionnel qui cherche des repères concrets pour arbitrer ses choix…
Ubuntu Server est un bon choix pour héberger des services Linux stables, à condition de préparer la version LTS, l'accès SSH, les mises à jour, le pare-feu et les sauvegardes.
Recherchez-vous un équipement capable de vous aider dans la gestion de votre organisation? Les imprimantes de codes-barres occupent une place importante dans de nombreux secteurs. Elles permettent d'identifier rapidement les produits, colis.
Un support utilisateur PME efficace ne repose pas seulement sur un outil de ticketing. Il clarifie les demandes, les priorités, les délais, l'escalade et la mémoire de résolution.
Sous Linux, supprimer un dossier dépend surtout de son contenu. Voici quelle commande choisir et les précautions à prendre avant une suppression récursive.