Certificat + clé privée
Indispensable
Sans clé privée, l’attaquant ne peut pas terminer une authentification TLS crédible.


Cybersécurité
Des certificats TLS non autorisés pour 1.1.1.1 ne signifient pas automatiquement que le résolveur DNS de Cloudflare a été piraté. Ils révèlent surtout un point plus profond : une partie de la confiance Internet repose encore sur des autorités capables d’émettre un certificat que certains clients accepteront, même lorsque le service concerné n’a rien demandé.
Dans ce dossier, la question utile n’est donc pas “Cloudflare a-t-il perdu le contrôle de son DNS ?”. La bonne lecture consiste à regarder qui a émis les certificats, quels clients pouvaient les accepter, comment l’anomalie a été détectée, puis ce qu’un administrateur doit vérifier dans son propre parc. C’est là que l’incident devient un vrai cas d’école PKI.
Le doute doit déclencher une procédure, pas une conclusion. C’est ce qui sépare l’analyse d’incident d’un simple emballement autour d’un certificat suspect.
Cloudflare indique avoir été alerté de certificats non autorisés émis pour l’adresse IP 1.1.1.1, utilisée par son résolveur DNS public. L’article legacy ne parlait que de trois certificats repérés en mai 2025. Les informations publiées ensuite élargissent le périmètre : l’entreprise mentionne désormais douze émissions par Fina CA, sur une période allant de février 2024 à août 2025.
Le point important tient dans le mot “émis”. Une autorité de certification a signé des certificats contenant 1.1.1.1 sans l’autorisation de Cloudflare. Cela ne prouve pas, en soi, que le trafic des utilisateurs a été intercepté. Cela prouve en revanche qu’un acteur tiers a pu produire un titre de confiance technique pour une adresse qui ne lui appartenait pas.
C’est précisément ce que la PKI doit empêcher, même lorsque le certificat n’a servi à aucune attaque observée. L’incident reste sérieux parce qu’il touche la logique même d’autorisation.
D’après Cloudflare, Fina a présenté l’affaire comme une erreur liée à des certificats de test. Cette explication ne retire pas le problème : des clés de production ne devraient pas servir à signer un certificat pour une adresse IP contrôlée par un autre opérateur. Dans une architecture de confiance, l’intention interne pèse moins que le résultat visible par les clients.
La majorité des certificats concernés ont ensuite été révoqués. Microsoft a aussi utilisé un mécanisme de révocation rapide pour empêcher l’usage des certificats identifiés dans son écosystème. La nuance est essentielle : une révocation ne garantit pas que chaque poste, chaque appliance et chaque client DNS l’appliquera immédiatement. Le temps de propagation reste un risque opérationnel.
Il faut également distinguer l’erreur déclarée et l’écart de contrôle. Les règles CA/B Forum imposent aux autorités de vérifier le contrôle ou l’autorisation avant d’émettre un certificat serveur. Quand une adresse IP connue comme 1.1.1.1 apparaît dans un certificat signé par une entité tierce, l’enjeu devient la preuve de validation : qui a demandé le certificat, quel mécanisme a été utilisé, quelle trace existe, et pourquoi l’émission n’a pas été arrêtée avant publication.
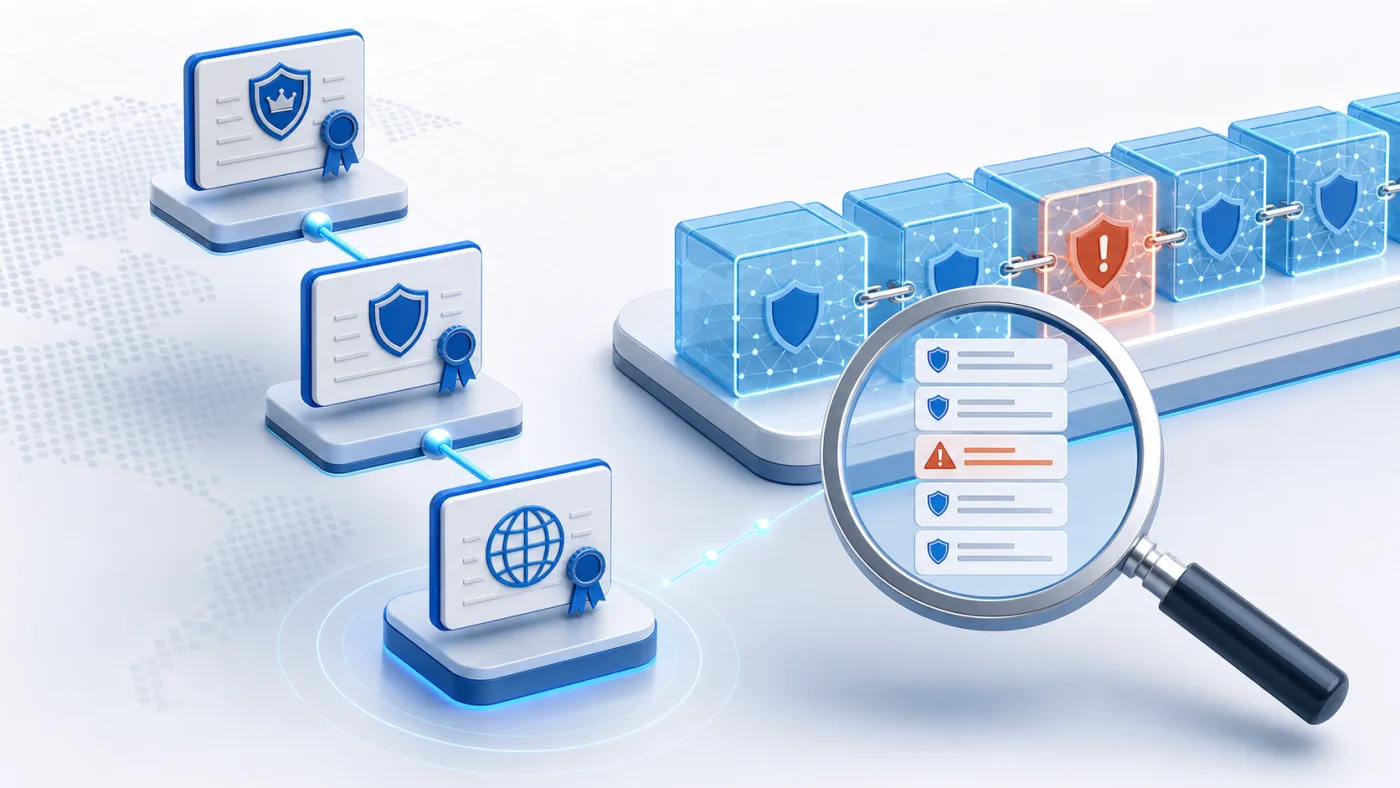
Le danger apparaît seulement quand plusieurs pièces s’alignent.
Un certificat TLS sert à prouver l’identité d’un service pendant l’établissement d’une connexion chiffrée. Pour du DNS chiffré, comme DNS over HTTPS ou DNS over TLS, il aide le client à vérifier qu’il parle bien au résolveur prévu. Si un certificat valable pour 1.1.1.1 est accepté par le client, un attaquant placé au bon endroit peut tenter une usurpation crédible.
Mais il manque souvent une étape dans les récits alarmistes. Le certificat seul ne suffit pas. Il faut aussi la clé privée correspondante, un client qui fait confiance à l’autorité émettrice, et une capacité d’interception ou de redirection du trafic. Sans cette combinaison, le certificat reste une anomalie grave, mais pas une preuve d’exploitation massive.
C’est ce qui rend l’incident intéressant pour les administrateurs. Il ne faut ni le minimiser, ni le transformer en scénario catastrophe automatique. Il faut raisonner en conditions d’exploitation.
Le contexte décide du risque, surtout quand le certificat touche un service très utilisé mais que l’exposition client reste conditionnelle. Cette phrase doit guider le tri des alertes.
Un certificat frauduleux devient réellement exploitable seulement si plusieurs conditions techniques se recoupent.
Indispensable
Sans clé privée, l’attaquant ne peut pas terminer une authentification TLS crédible.
Filtre majeur
Un navigateur ou un OS qui ne reconnaît pas la chaîne rejette le certificat.
Condition terrain
L’attaquant doit intercepter, détourner ou se placer sur le chemin du trafic.
Réduction du risque
La protection dépend de la vitesse à laquelle les clients appliquent les listes de blocage.
Dans un parc d’entreprise, la question n’est donc pas seulement “quel navigateur est utilisé ?”. Elle concerne aussi les services système, les proxies, les appliances, les agents de sécurité, les clients DoH/DoT autonomes, les environnements Windows, les conteneurs et les applications qui embarquent leur propre pile TLS. Le vrai périmètre est le magasin de confiance effectivement utilisé.
Pour approfondir ce point, consultez API : Décryptage d une interface programmation, qui traite plus précisément de api : décryptage d une interface programmation essentielle.
Un poste utilisateur peut être protégé pendant qu’un agent métier ne l’est pas. C’est souvent là que se cachent les angles morts d’un parc hybride.
La Certificate Transparency a joué son rôle de visibilité.
Elle rend les certificats publiquement observables dans des journaux append-only. Son intérêt est simple : un propriétaire de domaine, un opérateur ou un tiers peut surveiller ces journaux et repérer une émission inattendue. Dans cette affaire, le fait que les certificats aient été enregistrés dans ces journaux a permis leur découverte.
La limite est tout aussi importante. La CT ne bloque pas mécaniquement une autorité de certification au moment où elle signe. Elle fournit une preuve après émission, puis laisse aux opérateurs, aux navigateurs, aux magasins racine et aux systèmes de révocation le soin de réagir. Pour un domaine web classique, les navigateurs modernes imposent fortement cette logique. Pour certains clients DNS ou logiciels métier, l’exigence est moins homogène.
Autrement dit, la transparence est une alarme, pas un verrou physique. Elle aide à voir, puis à réagir.
Cette distinction évite une erreur fréquente dans les audits. Beaucoup d’équipes vérifient que leurs certificats légitimes expirent à temps, mais elles ne surveillent pas les certificats inattendus émis par d’autres. Pourtant, la surveillance CT devrait faire partie du socle pour les domaines, sous-domaines critiques, API publiques, marques, certificats wildcard et, quand c’est pertinent, adresses IP exposées.
Pour que cette surveillance serve réellement, elle doit être reliée à un contexte métier. Une alerte sur un nom de test ne demande pas la même urgence qu’une alerte sur un domaine de paiement, une API d’authentification, un portail client ou une adresse IP utilisée par une infrastructure publique. Le tri initial doit donc combiner criticité du service, visibilité externe, période de validité, autorité émettrice et possibilité d’exploitation réseau.
| Contrôle | Ce qu’il détecte | Ce qu’il ne garantit pas |
|---|---|---|
| Inventaire TLS interne | Certificats connus et expirations | Émissions externes non surveillées |
| Journaux CT | Certificats publiés dans les logs publics | Blocage immédiat de l’émission |
| Révocation CRL/OCSP | Certificats invalidés par l’écosystème | Application instantanée sur tous les clients |
| Magasin racine durci | Réduction des autorités acceptées | Protection contre les clients hors politique |
Le même certificat peut produire deux résultats opposés.
La raison tient aux magasins racine et aux politiques de chaque écosystème. Un client Windows, un navigateur qui utilise son propre root store, une application Java, une appliance réseau ou un conteneur Linux ne consultent pas toujours la même base de confiance.
Ce détail explique pourquoi l’incident 1.1.1.1 ne se résume pas à “les utilisateurs étaient exposés” ou “les utilisateurs étaient protégés”. Certains environnements pouvaient faire confiance à la chaîne Fina. D’autres non. Certains clients pouvaient recevoir rapidement une révocation. D’autres pouvaient dépendre d’une mise à jour, d’un proxy, d’une configuration locale ou d’un comportement logiciel spécifique.
Pour une DSI, ce point vaut plus que l’anecdote Cloudflare. Dans un audit d’infrastructure Linux/Unix, Windows ou hybride, il faut cartographier les stores de certificats réellement utilisés par les postes, serveurs, runtimes applicatifs, navigateurs, proxies TLS, outils EDR, sondes et agents de supervision. La confiance TLS est souvent plus fragmentée que ne le laisse penser la documentation d’architecture.
Ce n’est pas un sujet théorique. Une migration, une modernisation de parc ou une consolidation de proxy peut déplacer silencieusement la politique TLS d’un composant à un autre. Le changement semble propre, jusqu’au jour où un client ne valide plus comme prévu.
Ce déplacement est parfois invisible jusqu’au premier incident. Un serveur mis à jour peut rejeter une chaîne qu’il acceptait hier, tandis qu’un conteneur ancien peut continuer d’accepter une racine que l’OS hôte ne considère plus comme fiable. La bonne cartographie ne liste donc pas seulement des machines ; elle liste les chemins de validation réellement empruntés par les applications.
Sans inventaire, la confiance devient implicite, donc difficile à retirer proprement quand une racine ou un intermédiaire pose problème. L’équipe découvre alors la dépendance en urgence.
La bonne réponse n’est pas de paniquer sur 1.1.1.1. Elle consiste à utiliser l’incident comme test de maturité. Une équipe doit être capable de répondre à quatre questions : quels clients DNS chiffrés utilisons-nous, quels magasins racine leur servent de référence, comment la révocation est appliquée, et qui reçoit les alertes quand un certificat inattendu apparaît.
Le premier contrôle porte sur les résolveurs configurés. Si des postes utilisent DoH ou DoT vers un résolveur public, identifiez les clients, leurs versions, leurs politiques de validation et leurs chemins réseau. Dans une entreprise, le DNS chiffré non inventorié peut contourner des contrôles internes ou compliquer l’analyse d’incident.
Le deuxième contrôle concerne la révocation. Vérifiez si vos systèmes consultent correctement CRL ou OCSP, si les mises à jour de listes de certificats interdits sont distribuées, et si des environnements isolés conservent une confiance ancienne. Les machines hors ligne, les images anciennes, les appliances peu maintenues et certains conteneurs sont les candidats classiques.
Le troisième contrôle est la supervision. Une alerte CT utile doit être filtrée, assignée et testée. Une alerte noyée dans un flux bruyant n’est pas un contrôle, c’est une décoration de dashboard. Définissez une règle pour les domaines critiques, les noms sensibles, les IP exposées, puis testez l’escalade avec un scénario simulé.
Le quatrième contrôle est documentaire : conservez la décision, même si l’alerte est classée sans impact. Cette trace simplifie le prochain arbitrage.
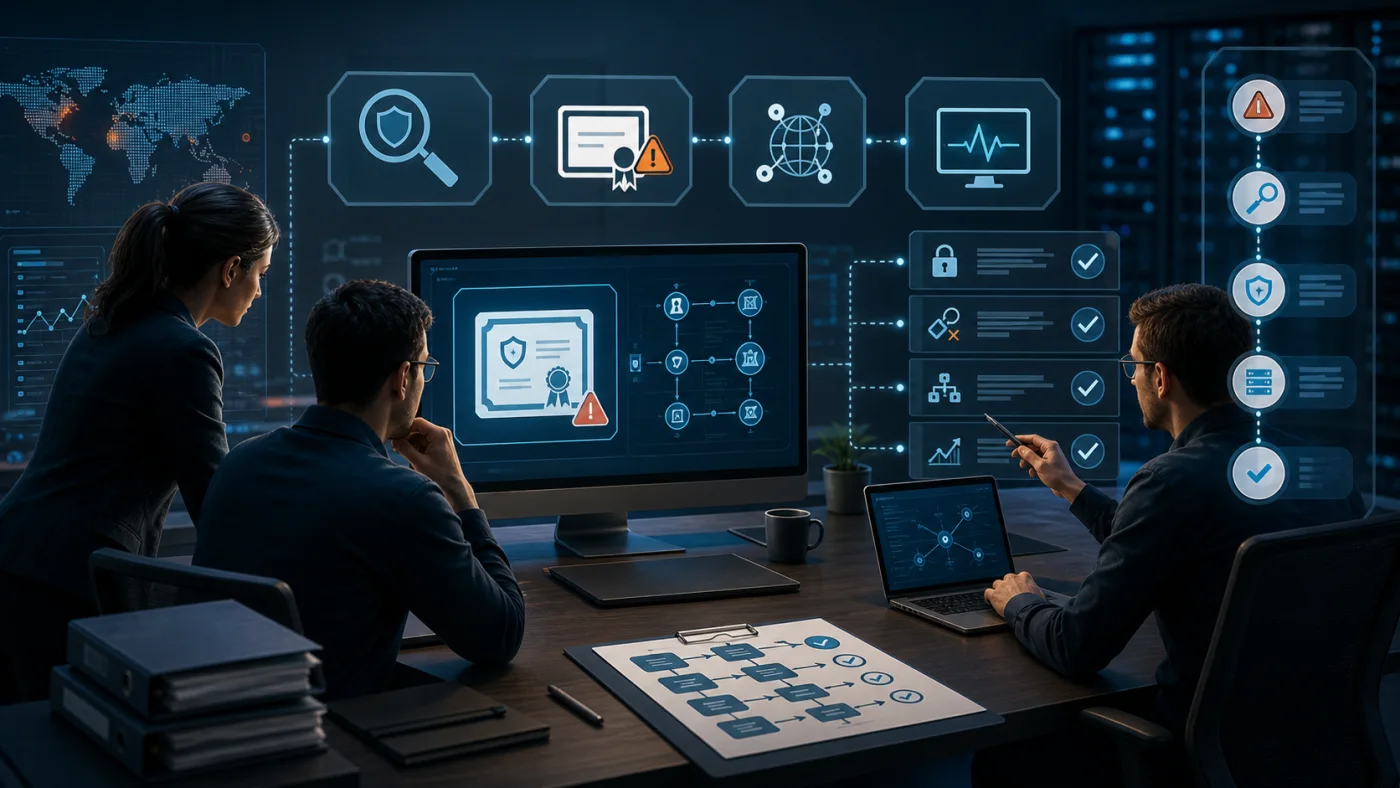
Sur un parc Linux, le piège consiste à croire que tout dépend d’un seul paquet de certificats. En pratique, une application peut utiliser le store système, un bundle embarqué, une JVM, une image conteneur ancienne ou une bibliothèque spécifique. Cette diversité est normale, mais elle exige une gouvernance explicite.
Lors d’une migration ou d’un audit, il faut donc vérifier comment les certificats racines sont distribués, mis à jour et éventuellement retirés. Un durcissement raisonnable peut limiter les autorités inutiles, mais il doit être testé. Retirer une racine sans analyse peut casser un flux métier légitime, tandis qu’un store trop large augmente la surface de confiance inutile.
La bonne pratique consiste à traiter la confiance TLS comme un composant d’infrastructure. Elle doit avoir un propriétaire, une politique, des journaux, un canal de mise à jour et une procédure de rollback. Sans cela, la révocation d’urgence dépendra de gestes manuels au pire moment.
Le cas 1.1.1.1 rappelle aussi que le DNS mérite une attention particulière. Le DNS chiffré améliore la confidentialité et l’intégrité du transport, mais il ne remplace pas une politique de résolution cohérente. Entre résolveurs publics, DNS interne, split-horizon, sécurité endpoint et proxy, le risque apparaît souvent dans les exceptions.
Dans une architecture hybride, ces exceptions s’accumulent vite : postes nomades, VPN fractionné, images de build, environnements de test, outils SaaS et scripts d’administration. Une politique claire doit dire quand un résolveur public est autorisé, quand il doit être remplacé par un résolveur interne, et comment vérifier la chaîne TLS du résolveur sans casser l’usage quotidien.
Si une alerte remonte sur un certificat inattendu, commencez par qualifier l’objet. S’agit-il d’un domaine interne, d’un domaine public, d’un wildcard, d’un certificat pour une IP, ou d’un nom qui ressemble à votre marque ? Ensuite, récupérez la chaîne complète, les SAN, l’émetteur, la période de validité, les SCT et les informations de révocation. Ce premier paquet de preuves évite les décisions à l’aveugle.
Ensuite, évaluez l’exposition client. Quels environnements feraient confiance à cette chaîne ? Le certificat cible-t-il un service critique ? Une interception réseau est-elle plausible ? Les logs de proxy, DNS, pare-feu, EDR ou routage montrent-ils une anomalie ? Ces questions transforment une alerte générique en risque exploitable ou en incident à faible impact.
Le diagnostic peut suivre une séquence courte. Elle doit rester assez simple pour être exécutée sous pression :
Le dernier temps est la remédiation. Contactez l’autorité de certification, activez les blocages disponibles, informez les équipes de support, surveillez la propagation de la révocation et conservez le rapport d’incident. Dans les organisations matures, la trace écrite compte autant que la correction : elle permet de prouver ce qui a été vérifié, par qui et à quel moment.
Une bonne fiche d’incident reste courte : certificat, chaîne, clients exposés, décision, preuve de révocation, contrôle après coup. Si elle demande vingt pages pour être comprise, elle arrivera trop tard.
Un incident de certification touche plusieurs responsabilités. L’autorité de certification doit vérifier le contrôle du domaine ou de l’adresse. Le propriétaire du service doit surveiller les émissions qui le concernent. Les root programs doivent pouvoir imposer des exigences et retirer la confiance si nécessaire. Les équipes IT doivent enfin savoir si leurs clients appliquent les politiques attendues.
Cette chaîne de responsabilités fonctionne seulement si chacun détecte et corrige vite. Ici, Cloudflare reconnaît aussi des faiblesses dans sa propre surveillance, notamment autour des certificats pour IP et du bruit d’alertes. Ce point est utile : même un opérateur très avancé peut manquer une anomalie visible si le signal n’est pas routé vers la bonne équipe.
Pour une entreprise plus petite, la leçon est directe. Il vaut mieux un nombre limité d’alertes bien qualifiées qu’un outil sophistiqué que personne ne lit. La sécurité opérationnelle se joue souvent dans cette discipline : réduire le bruit, documenter la décision, puis tester régulièrement que le chemin d’escalade fonctionne.
Le minimum viable est accessible : une liste des domaines critiques, une surveillance CT, un propriétaire désigné, et un test trimestriel de révocation sur quelques environnements représentatifs. Ce socle ne remplace pas un programme PKI complet, mais il donne déjà une capacité de réaction mesurable lorsque l’écosystème de confiance dérape.
La confiance ne se décrète pas ; elle se vérifie. Et cette vérification doit survivre aux changements de parc.
Le cas 1.1.1.1 est utile parce qu’il déplace le sujet du sensationnel vers l’opérationnel. Une émission TLS non autorisée peut rester sans exploitation visible et révéler malgré tout une faiblesse réelle : trop d’organisations connaissent leurs certificats, mais pas assez leur surface de confiance. C’est cette surface qu’il faut maintenant inventorier, surveiller et tester.
À lire aussi

Passer de l'administration système à la cybersécurité: acquis, métiers accessibles et parcours de formation.

Un guide complet pour prioriser la cybersécurité PME: phishing, MFA, sauvegardes, postes, prestataires, incident et gouvernance sans jargon inutile.
Le compte administrateur intégré de Windows 10 peut aider au dépannage, mais il ne doit pas devenir un compte de travail permanent.
Guide pratique pour choisir un installer for Windows fiable: formats, sources, mode silencieux, tests, deploiement et desinstallation.
Guide pratique pour telecharger Windows sans risque: canal officiel, edition, licence, cycle de vie, test et tracabilite dans un parc IT.
Panne, ransomware, erreur humaine: le mê me risque Un disque qui lâ che, un ranç ongiciel qui chiffre les fichiers, un dossier supprimé par erreur: trois causes diffé rentes, un seul point commun. Sans copie.
