
Supervision lisible
Surveillez débit, latence, tunnels VPN et alertes pour repérer une saturation avant la coupure.


Logiciels Services
Un routeur sert à faire circuler les données entre plusieurs réseaux. Dans une PME, il ne se limite pas à “donner Internet” : il relie le réseau local au fournisseur d’accès, sépare parfois plusieurs zones internes, applique des règles de sécurité et décide par quel chemin chaque paquet doit sortir. Comprendre le rôle du routeur aide à diagnostiquer les lenteurs, les coupures et les risques de configuration.
Pour approfondir ce point, consultez chatgpt données entreprise, qui traite plus précisément de utiliser chatgpt au travail sans exposer les données de l’entreprise.
La box d’un particulier remplit déjà une partie de ces fonctions. En entreprise, le sujet devient plus sensible, car le routeur porte souvent la passerelle Internet, le VPN, le DHCP, le filtrage, les règles NAT et parfois la segmentation entre Wi-Fi invité, postes utilisateurs, serveurs et objets connectés.
Le routeur travaille principalement à la couche réseau. Il lit l’adresse IP de destination d’un paquet, consulte sa table de routage, puis envoie ce paquet vers la bonne interface. Cette décision peut sembler instantanée, mais elle conditionne toute la communication entre un poste de travail, un serveur interne, une application cloud ou un site distant.
Dans un réseau simple, le routeur envoie presque tout vers la passerelle Internet. Dans un réseau professionnel, il peut distinguer plusieurs chemins : réseau local, VPN inter-sites, lien fibre principal, secours 4G/5G, VLAN invités, sous-réseau de serveurs ou accès d’administration. Le prochain saut n’est donc pas toujours le même.
Autrement dit, il décide où va le trafic, même quand l’utilisateur ne voit qu’une page web qui s’ouvre ou une application qui répond.
Cette fonction explique pourquoi une panne de routeur bloque souvent plus que le Wi-Fi. Les appareils peuvent encore voir le réseau local, mais ne plus joindre Internet, un serveur distant ou une application métier. Le diagnostic doit alors vérifier si le problème vient du lien physique, de l’adresse IP, de la route, du DNS ou d’une règle de sécurité.
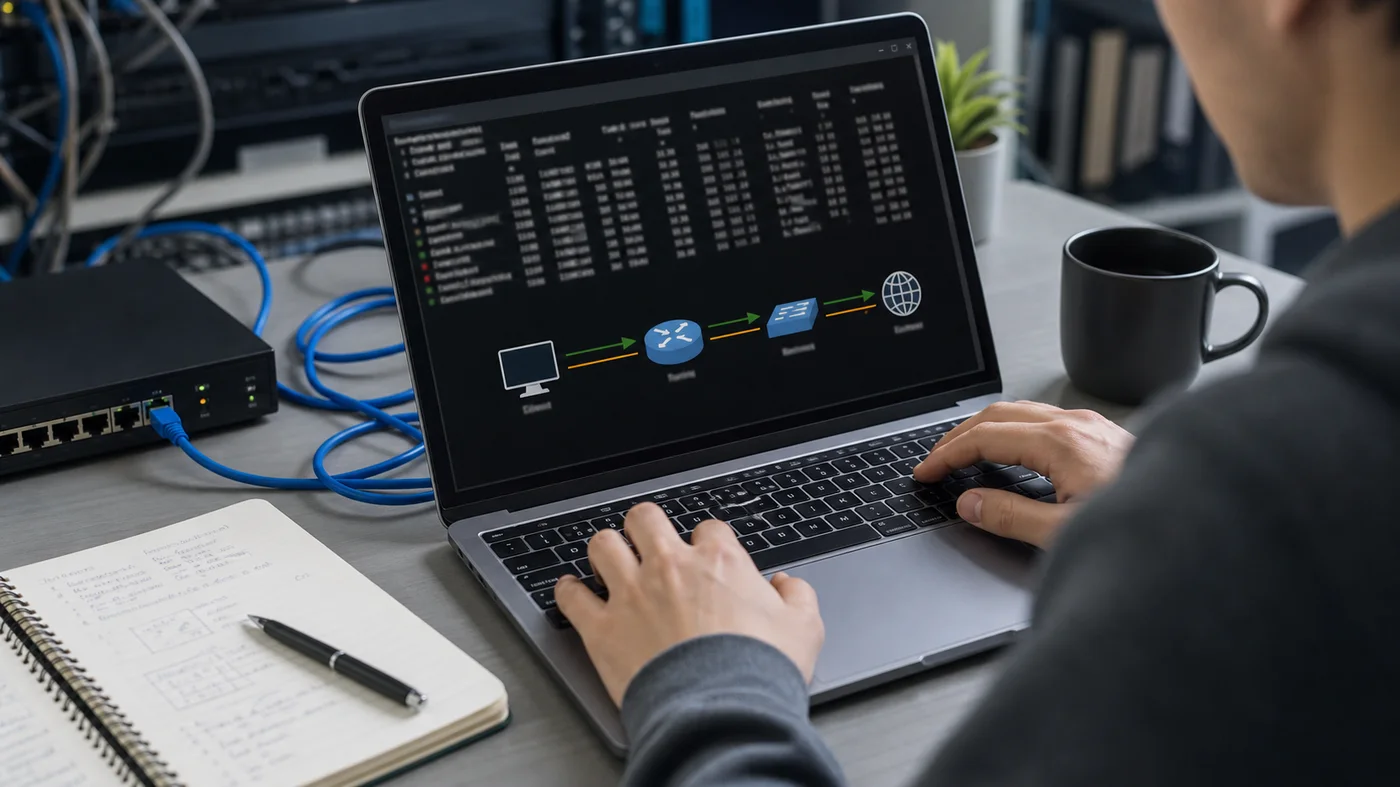
C’est la pièce à lire quand le chemin réseau ne semble plus logique, surtout après un changement d’opérateur, de VPN ou de sous-réseau. Une table de routage contient des destinations, des masques, des passerelles, des interfaces et des métriques. Quand un paquet arrive, le routeur cherche l’entrée la plus précise correspondant à l’adresse cible. Si aucune route spécifique n’existe, il utilise généralement la route par défaut, souvent notée 0.0.0.0/0 en IPv4.
Ce mécanisme permet de gérer des cas très différents. Le trafic vers 192.168.10.0/24 peut rester dans un réseau interne, tandis que le trafic vers Internet part vers le fournisseur d’accès. Un flux vers une agence distante peut passer par un tunnel VPN. Un lien de secours peut rester inactif jusqu’à la panne du lien principal. Le routeur n’invente pas le chemin au hasard : il applique une priorité de routes que l’administrateur doit pouvoir relire.
Pour approfondir ce point, consultez switch réseau, qui traite plus précisément de switch réseau, comprendre son rôle sans se tromper.
| Élément | Rôle | Exemple courant |
|---|---|---|
| Destination | Réseau ou plage à joindre | 192.168.10.0/24 |
| Passerelle | Routeur suivant | 192.168.1.1 |
| Interface | Port ou lien utilisé | WAN, LAN, VPN |
| Métrique | Priorité du chemin | Route principale avant secours |
Pour une PME, cette table reste souvent invisible jusqu’au jour où un VPN ne répond plus ou qu’un nouveau sous-réseau est ajouté. Pourtant, une erreur de masque, une passerelle mal renseignée ou une route plus prioritaire que prévu peut suffire à créer une panne partielle, difficile à repérer si l’on se contente de redémarrer la box.
La plupart se corrigent mieux avec une méthode qu’avec un redémarrage, car les symptômes masquent souvent une cause très précise. Les incidents de routage viennent rarement d’un seul défaut spectaculaire. Ils apparaissent plutôt après une petite modification : ajout d’une imprimante, changement d’opérateur, nouveau VLAN, VPN temporaire devenu permanent ou remplacement d’une box par un routeur plus complet. Si personne ne met à jour le plan réseau, la configuration réelle finit par diverger de ce que l’équipe croit utiliser.
Le cas le plus classique reste le mauvais masque de sous-réseau. Deux postes semblent proches, mais ne se trouvent pas dans la même plage IP. Le routeur reçoit alors du trafic qu’il ne devrait pas traiter, ou un appareil cherche localement une destination qui devrait passer par la passerelle. Ce type d’erreur produit des symptômes intermittents, surtout lorsque certains postes gardent d’anciens paramètres en cache.
Autre piège : ouvrir une règle pour régler vite un blocage applicatif, puis l’oublier. Une exception firewall trop large, un port exposé sans justification ou un ancien accès VPN conservé après un départ salarié ne cassent pas toujours le réseau, mais augmentent le risque. La bonne pratique consiste à dater les règles sensibles, à indiquer leur raison et à les revoir régulièrement.
Un réseau stable se reconnaît à sa documentation, parce qu’elle transforme un incident confus en série de vérifications simples.
Beaucoup d’équipements regroupent plusieurs fonctions, ce qui entretient la confusion. Le routage décide du chemin. Le NAT traduit des adresses privées vers une adresse publique ou inversement. Le DHCP distribue automatiquement des adresses IP aux postes. Le DNS traduit des noms de domaine en adresses IP. Sur une petite installation, tout cela peut être porté par le même boîtier, mais les rôles doivent rester séparés dans le raisonnement, surtout quand une panne ne touche qu’une partie des usages.
Cette concentration est pratique, mais elle rend les diagnostics plus délicats. Si un poste ne navigue plus, la cause peut être un bail DHCP expiré, un DNS indisponible, une règle NAT absente, une route manquante ou un filtrage sortant trop strict. Les symptômes se ressemblent, mais les corrections sont très différentes.
Pour approfondir ce point, consultez fondateur Facebook, qui traite plus précisément de qui a fondé facebook et quel rôle ont joué les cofondateurs.
En entreprise, séparer clairement ces rôles dans la documentation évite les interventions hasardeuses. Une fiche simple avec le plan IP, la passerelle, les serveurs DNS, les VLAN et les règles principales fait gagner beaucoup de temps lors d’un incident ou d’un changement de prestataire.
Ces trois équipements ne résolvent pas le même problème. Même réunis dans une seule box, ils doivent être pensés séparément.
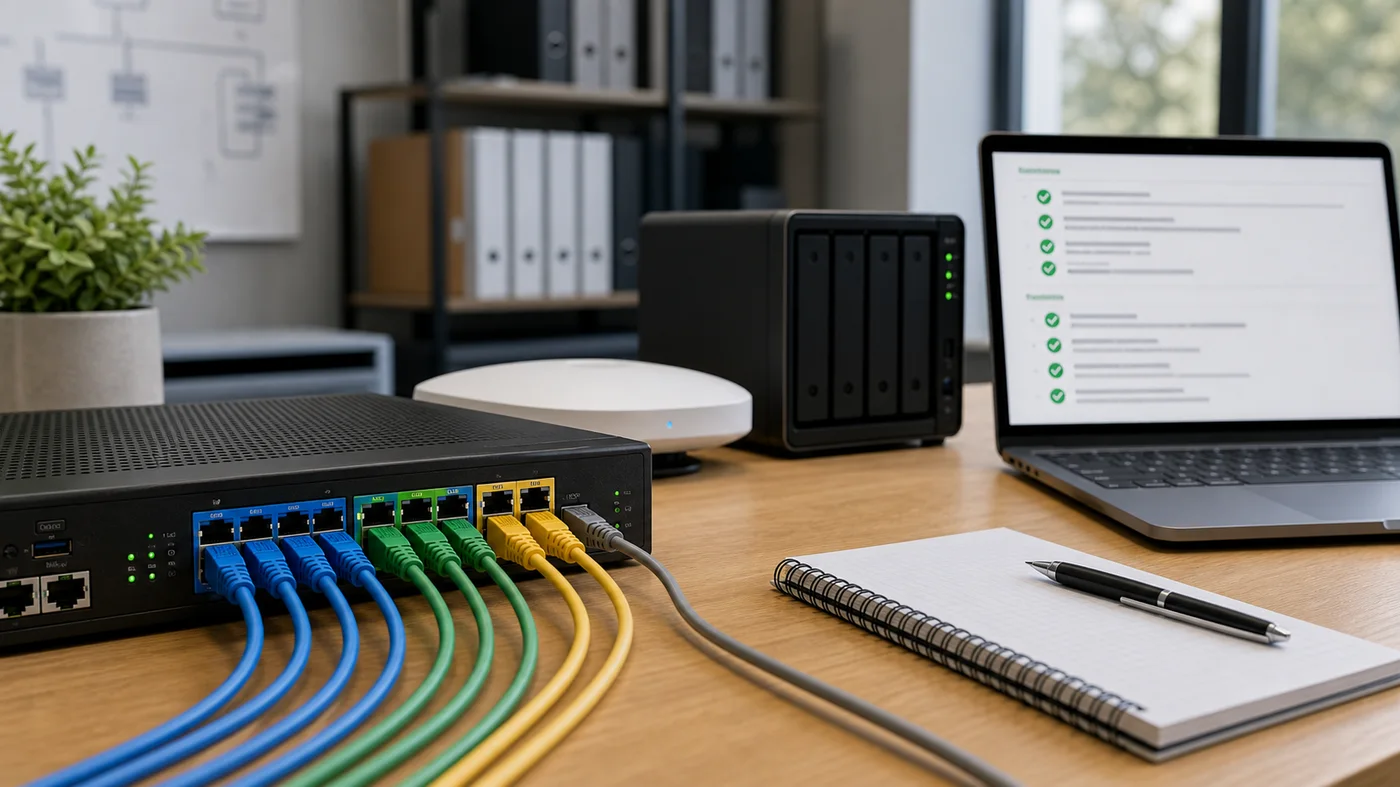
Un switch relie plusieurs appareils dans un même réseau local. Un point d’accès Wi-Fi fournit une connexion sans fil. Un routeur relie des réseaux différents. Les trois peuvent être intégrés dans une box ou séparés dans une architecture plus professionnelle. La séparation devient utile dès que le réseau grandit.
Dans une PME, il est fréquent de garder un routeur ou firewall central, des switches administrables pour les bureaux et plusieurs points d’accès Wi-Fi. Cette architecture permet d’améliorer la couverture sans fil, de gérer des VLAN, d’isoler les invités et de remplacer un élément sans refaire tout le réseau.
Pour compléter cette lecture, cookies web apporte des repères utiles sur cookies web, comprendre leur rôle sans subir le pistage.
Un mauvais choix consiste à demander au Wi-Fi de corriger un problème de routage ou au routeur de compenser une couverture radio trop faible. Chaque couche a son rôle. Quand elles sont documentées, les incidents deviennent plus lisibles : panne Internet, boucle réseau, mauvaise borne Wi-Fi, saturation du switch ou règle firewall mal placée.
Le routeur est aussi une frontière de confiance, entre l’entreprise, Internet, les invités, les sites distants et les équipements sensibles. S’il est mal configuré, il peut exposer l’administration, ouvrir des ports inutiles, laisser un Wi-Fi invité accéder au réseau interne ou conserver un firmware vulnérable. La sécurité commence donc par des gestes simples : mot de passe unique, administration limitée, mises à jour, sauvegarde de configuration et journalisation.
La segmentation est un autre levier important. Les postes utilisateurs, imprimantes, caméras, serveurs, invités et objets connectés ne devraient pas toujours partager le même espace réseau. Avec des VLAN et des règles de filtrage, on limite la propagation d’un incident et on évite qu’un appareil secondaire devienne une porte d’entrée vers les données sensibles. Cette séparation doit rester compréhensible : trop de règles opaques peuvent créer une fausse sécurité, car plus personne n’ose les modifier.
Le VPN doit également être traité avec sérieux. Un accès distant pratique mais peu contrôlé peut devenir un risque majeur. Authentification forte, comptes nominatifs, profils d’accès limités et révocation rapide des anciens comptes sont des exigences de base, même pour une petite structure.
Commencez par situer l’étendue de la panne. Une règle ne doit pas être modifiée avant ce premier tri.
Pour approfondir ce point, consultez opc serveur, qui traite plus précisément de serveur opc, comprendre son rôle dans l’industrie.
Un bon diagnostic commence par une question simple : le problème touche-t-il un poste, un service, un réseau ou tout le site ? Si un seul ordinateur est concerné, vérifiez son adresse IP, sa passerelle et son DNS. Si tout le bureau est touché, regardez le routeur, le lien WAN, les logs et l’état des interfaces.
Les commandes de base restent utiles. Un ping vers la passerelle vérifie le lien local. Un ping vers une adresse publique teste la sortie IP. Une résolution DNS teste le nommage. Un traceroute montre où le chemin s’interrompt. Cette progression évite de modifier la configuration du routeur avant de savoir quelle couche est réellement en cause.
Pour les environnements professionnels, la supervision change tout. Un graphe de débit, un historique de latence, des alertes sur les tunnels VPN et une sauvegarde des configurations permettent de distinguer une panne franche d’une saturation progressive. Sans historique, on répare souvent à l’aveugle.
À suivre avant de remplacer un routeur ou de modifier les règles.
La fiche technique ne suffit pas. Les débits annoncés ne disent rien de l’exploitation réelle, ni de la clarté des règles.
Pour compléter cette lecture, NAT PAT apporte des repères utiles sur comprendre nat et pat sans ouvrir trop largement son réseau.
Le bon routeur n’est pas forcément le plus cher. Il doit tenir le débit réel, le nombre d’utilisateurs, les tunnels VPN, la segmentation, les règles de sécurité et la supervision attendue. Une petite équipe avec fibre simple n’a pas les mêmes besoins qu’une entreprise multi-sites avec télétravail régulier et applications hébergées.
Les critères à regarder sont concrets : débit WAN avec filtrage activé, nombre de ports, prise en charge VLAN, VPN site-à-site et nomade, haute disponibilité, mises à jour, logs exploitables, sauvegarde/restauration de configuration et support. Le Wi-Fi intégré peut dépanner, mais des points d’accès dédiés sont souvent plus propres pour couvrir des bureaux.
Il faut aussi anticiper l’exploitation. Un routeur puissant mais incompris devient un risque. Pour une PME sans administrateur réseau, mieux vaut une solution administrable, documentée et supervisée qu’un équipement très avancé laissé avec une configuration floue.
IPv6 ne doit pas rester un angle mort, même dans une entreprise qui pense encore fonctionner uniquement en IPv4.
La plupart des PME vivent encore avec IPv4, souvent derrière du NAT, parce que les adresses privées restent simples à gérer et que de nombreux équipements métiers ont été conçus dans cet environnement. IPv6 change la logique : les adresses sont beaucoup plus nombreuses, le NAT n’a pas le même rôle, et la configuration de sécurité doit être pensée explicitement.
Pour approfondir ce point, consultez protocole TCP, qui traite plus précisément de protocole tcp : définition simple, rôle et différence avec udp.
Un routeur moderne doit donc savoir travailler en double pile IPv4/IPv6, ou au minimum permettre de maîtriser ce qui est activé. Le risque classique est d’avoir IPv6 disponible sans filtrage cohérent, pendant que l’équipe pense encore raisonner uniquement en IPv4. Dans ce cas, une partie du trafic peut contourner les réflexes de diagnostic habituels.
Pour une petite entreprise, la bonne approche consiste à documenter l’état réel : IPv6 est-il fourni par l’opérateur ? Les postes l’utilisent-ils ? Les règles firewall couvrent-elles les deux piles ? Les outils de supervision voient-ils les deux types d’adresses ? Cette vérification évite les angles morts réseau, surtout lors d’une migration de fournisseur ou de firewall.
Le choix dépend surtout de la taille réelle du réseau. Plusieurs chemins possibles changent la réponse.
Le routage statique est simple : un administrateur écrit les routes à la main. Il convient aux petits réseaux, aux chemins stables et aux environnements où les changements sont rares. Son avantage est la lisibilité. Son défaut est évident : si le réseau évolue, si un lien tombe ou si un nouveau site apparaît, il faut mettre à jour la configuration.
Le routage dynamique utilise des protocoles comme OSPF, BGP ou, dans des contextes plus anciens, RIP. Ces protocoles permettent à plusieurs routeurs d’échanger des informations sur les chemins disponibles. Ils deviennent utiles pour les sites multiples, les liens redondants, les réseaux plus grands ou les environnements où la continuité de service compte vraiment.
Il ne faut pas activer du routage dynamique pour paraître plus avancé. Mal paramétré, il ajoute de la complexité et rend les incidents moins lisibles. La question à poser est pragmatique : les routes changent-elles souvent ? Avez-vous plusieurs chemins ? Faut-il basculer automatiquement ? Si la réponse est non, des routes statiques bien documentées peuvent être préférables.
La continuité se prépare avant l’incident. C’est à ce moment qu’il reste le temps de choisir le bon niveau de secours.
Dans beaucoup de PME, le routeur devient un point unique de défaillance. S’il tombe, l’accès Internet, le VPN, la téléphonie IP et parfois les applications cloud s’arrêtent ensemble. Cette dépendance doit être connue avant l’incident. Un lien fibre rapide ne suffit pas si le routeur, l’alimentation ou la configuration ne disposent d’aucun plan de secours, surtout quand le standard téléphonique, la caisse, la gestion commerciale et les outils collaboratifs passent tous par le même accès WAN.
La redondance peut prendre plusieurs formes : double accès Internet, secours 4G/5G, routeur de remplacement prêt à configurer, alimentation protégée, sauvegarde récente, supervision externe ou bascule automatique. Le bon niveau dépend de l’impact métier. Une agence qui travaille dans le cloud toute la journée n’a pas le même besoin qu’un petit bureau qui peut fonctionner quelques heures hors ligne.
Pour approfondir ce point, consultez l’adresse MAC avant de sécuriser un réseau, qui traite plus précisément de comprendre l’adresse mac avant de sécuriser un réseau local.
Le seuil acceptable doit être décidé avant la coupure, quand la pression opérationnelle ne brouille pas encore les priorités.
La continuité ne se résume pas au matériel. Il faut savoir où se trouve la dernière sauvegarde de configuration, qui peut l’appliquer, quels services doivent revenir en premier et comment communiquer pendant la panne. Une procédure courte, testée une fois par an, vaut mieux qu’un équipement haut de gamme que personne ne sait restaurer.
Le routeur doit être exploitable dans la durée, pas seulement fonctionnel le jour de l’installation.
Surveillez débit, latence, tunnels VPN et alertes pour repérer une saturation avant la coupure.

Préparez le lien de secours, la sauvegarde de configuration et la personne capable de restaurer.
L’exploitation compte autant que l’installation. Un routeur jamais relu finit toujours par accumuler des zones floues.
Un routeur bien installé mais jamais suivi finit par devenir une boîte noire. Les mises à jour sont repoussées, les règles s’empilent, les anciens comptes VPN restent actifs et les journaux ne sont consultés qu’après un incident. L’exploitation quotidienne doit rester légère, mais elle doit exister.
Les contrôles utiles sont simples : vérifier les mises à jour, sauvegarder la configuration après chaque changement, revoir les règles ouvertes, supprimer les comptes inutiles, surveiller l’usage WAN et tester les accès VPN. Ces gestes maintiennent un réseau compréhensible et réduisent les mauvaises surprises lors d’un audit, d’un départ salarié ou d’une migration opérateur.
Le meilleur indicateur reste la capacité à expliquer le fonctionnement du réseau sans improviser. Si personne ne sait pourquoi une règle existe, quel port est exposé ou quel tunnel relie deux sites, le routeur n’est plus seulement un équipement technique : il devient une dette d’exploitation.
Un routeur fiable est un routeur compris, documenté et maintenu avec assez de régularité pour rester lisible.
Un routeur est le décideur de circulation du réseau. Il ne se contente pas de fournir Internet : il choisit les chemins, applique des règles, relie des zones et conditionne une partie de la sécurité. Dans une PME, un routeur bien configuré réduit les pannes floues et rend les incidents plus faciles à isoler.
La priorité est de documenter le plan IP, les routes, les règles principales, les accès VPN et les sauvegardes de configuration. Ensuite seulement vient le choix du matériel. Un réseau fiable repose moins sur un boîtier spectaculaire que sur une architecture lisible, maintenable et adaptée aux usages.
Pour approfondir ce point, consultez newsletter entreprise, qui traite plus précisément de newsletter d’entreprise, bâtir un rendez-vous que les abonnés gardent.
À lire aussi
Guide pratique pour comprendre Safari on Windows, eviter les anciens installateurs et choisir une methode de test Safari ou WebKit fiable.

Steam fonctionne sur Linux, mais l'expérience dépend surtout du jeu, de Proton, des pilotes graphiques et de la distribution utilisée.

PDFsam peut être utile quand il faut organiser des PDF en local, mais il ne remplace pas tous les éditeurs PDF.

Un PDF se modifie en ligne pour des corrections simples, mais pas pour tous les documents ni tous les usages sensibles.

Tiny10 peut redonner de l'air à un vieux PC, mais cette image Windows modifiée n'a pas le même niveau de garantie qu'une installation officielle.

Pour fusionner des PDF avec iLovePDF, l'essentiel est de préparer l'ordre des fichiers, contrôler le résultat et éviter d'envoyer des documents sensibles sans réflexion.
